목표
서버 1대짜리 구조를 여러 AZ에 분산된 다중 서버 구조로 전환하고, 장애 발생 시 자동으로 복구되는지 검증한다.
A. AMI 생성 및 대상 그룹 준비
상황
지금까지 서버는 한 대뿐이었다. 이제 여러 대로 늘려야 하는데, 두 번째·세 번째 서버를 매번 처음부터 만들면 EC2 생성 → Nginx 설치 → 설정을 서버 수만큼 반복해야 한다.
AMI를 만든 이유
잘 돌아가는 지금 서버를 통째로 이미지로 떠두면, 그 이미지로 찍어낸 서버는 Nginx가 이미 설치된 상태로 생성된다. 붕어빵 틀을 만들어 두는 것과 같다.
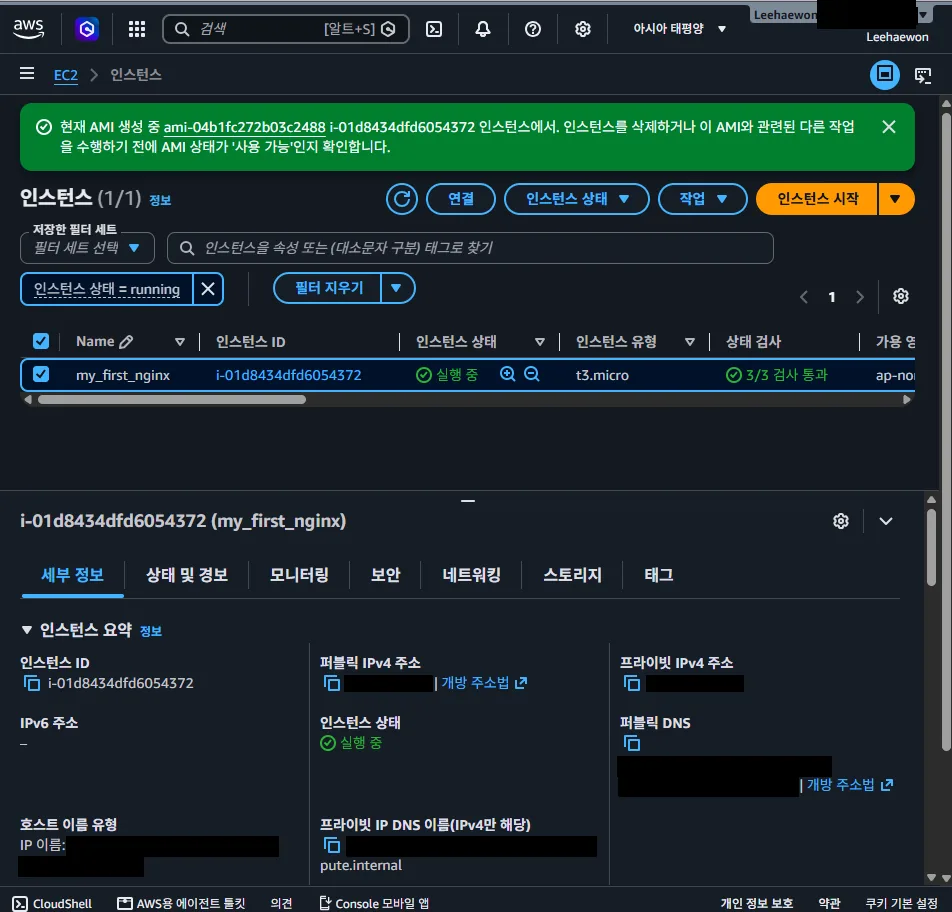
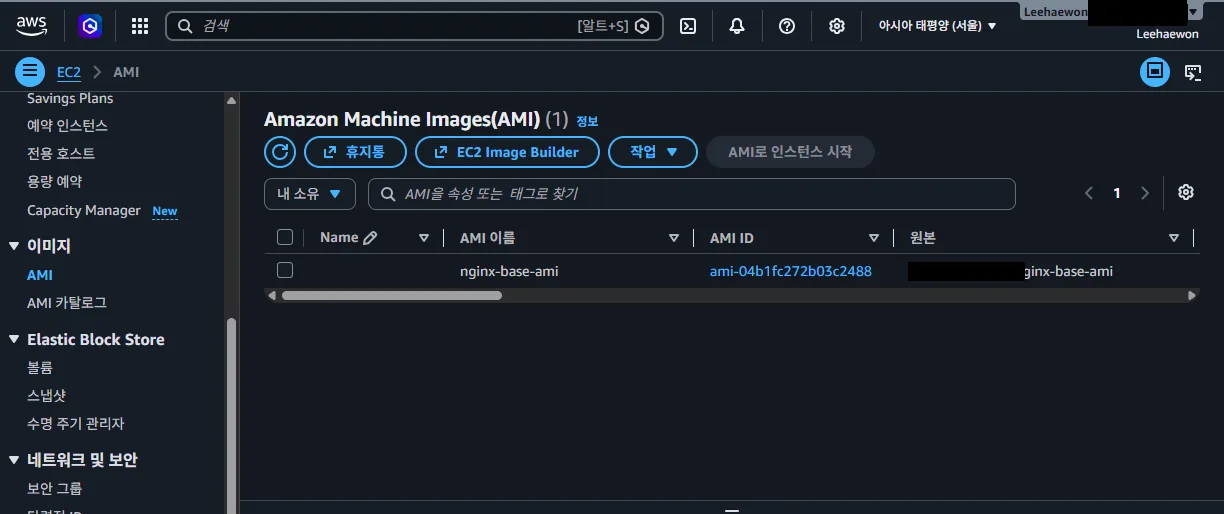
EC2-> 인스턴스 -> 작업 -> 이미지 및 템플릿 -> 이미지 생성- 이미지 이름:
nginx-base-ami - 상태가
available이 되어야 사용 가능
대상 그룹 생성
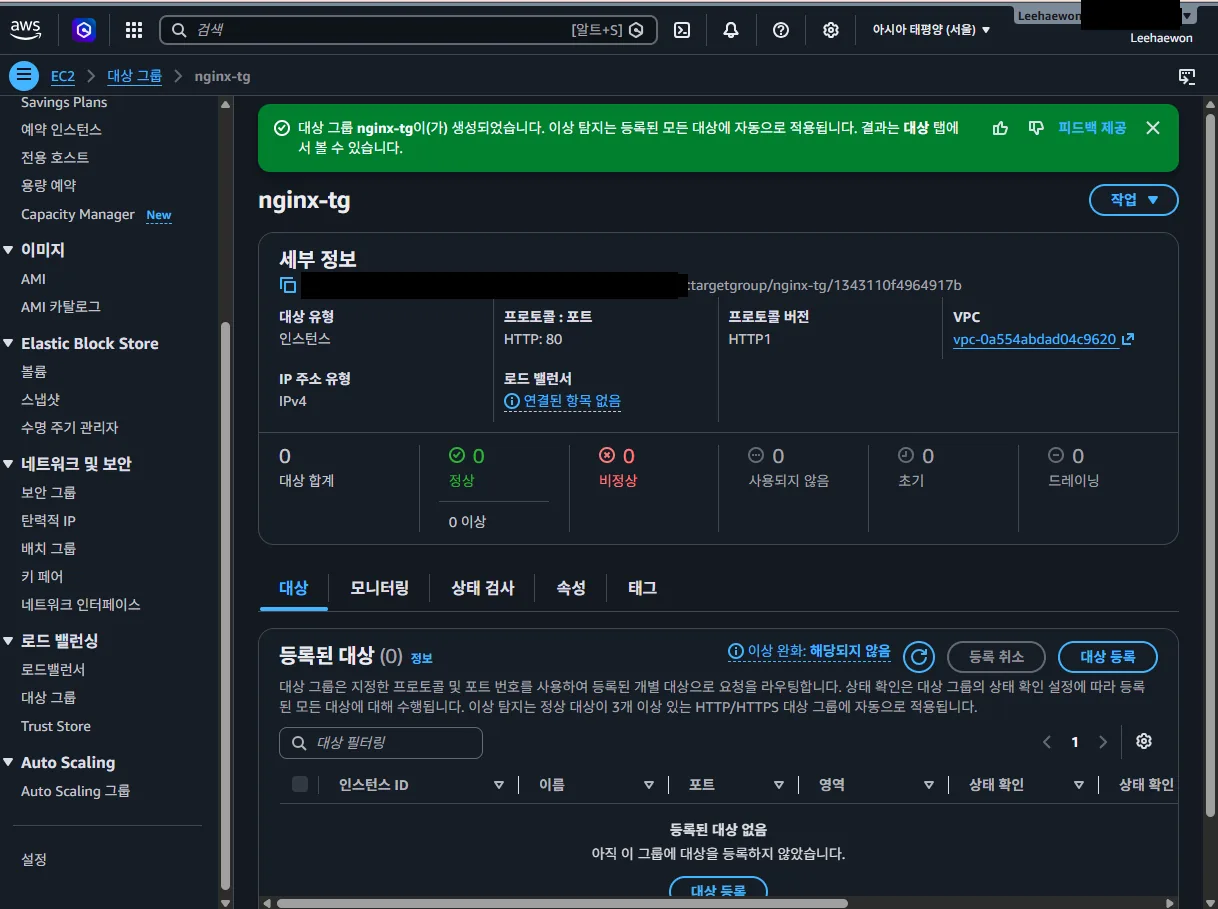
EC2 → 로드 밸런싱 → 대상 그룹 → 대상 그룹 생성- 이름
nginx-tg - 대상 유형: 인스턴스 / 프로토콜·포트: HTTP 80
- VPC:
vpc-0a554abdad04c9620 - 상태 검사 경로:
/ - 인스턴스는 등록하지 않고 생성 (ASG가 자동으로 등록)
대상 그룹을 만든 이유
대상 그룹은 ALB가 트래픽을 보낼 서버들의 명단이다. ALB에 EC2를 바로 연결하지 않고 명단을 따로 두는 이유는 두 가지의 관심사가 다르기 때문이다.
| 구성 요소 | 담당하는 것 |
|---|---|
| ALB | 어떤 주소로 들어온 요청을 받을 것인가 |
| 대상 그룹 | 그 요청을 어떤 서버들에게 · 몇 번 포트로 보내고 · 살아있는지 어떻게 확인할 것인가 |
분리해두면 나중에 서버 구성이 통째로 바뀌어도 ALB는 건드리지 않고 명단만 교체하면 된다.
상태 검사 경로를 /로 둔 이유
ALB가 주기적으로 이 경로로 요청을 보내 서버가 응답하는지 확인한다. 존재하는 경로여야 정상 응답이 오고, 이 확인 결과가 나중에 자동 복구의 출발점이 된다.
인스턴스를 등록하지 않고 생성한 이유
ASG가 서버를 만들 때 자동으로 명단에 등록해 주기 때문이다. 손으로 등록하면 ASG가 서버를 교체할 때마다 다시 손으로 고쳐야 한다.
B. ALB 구성 및 보안 그룹 재설정
상황
A에서 서버를 찍어낼 틀(AMI)과 서버 명단(대상 그룹)을 만들었다. 이제 그 명단으로 트래픽을 보내줄 입구를 만들 차례다. 지금까지는 사용자가 EC2의 퍼블릭 IP로 직접 접속했다. 서버가 여러 대가 되면 이 방식은 성립하지 않는다. 사용자가 "오늘은 A서버, 내일은 B서버" 하고 주소를 바꿔가며 접속할 수는 없기 때문이다. 그래서 주소는 하나로 두고, 뒤에서 여러 서버에 나눠주는 장치가 필요하다. 그게 로드 밸런서다.
ALB용 보안 그룹 생성
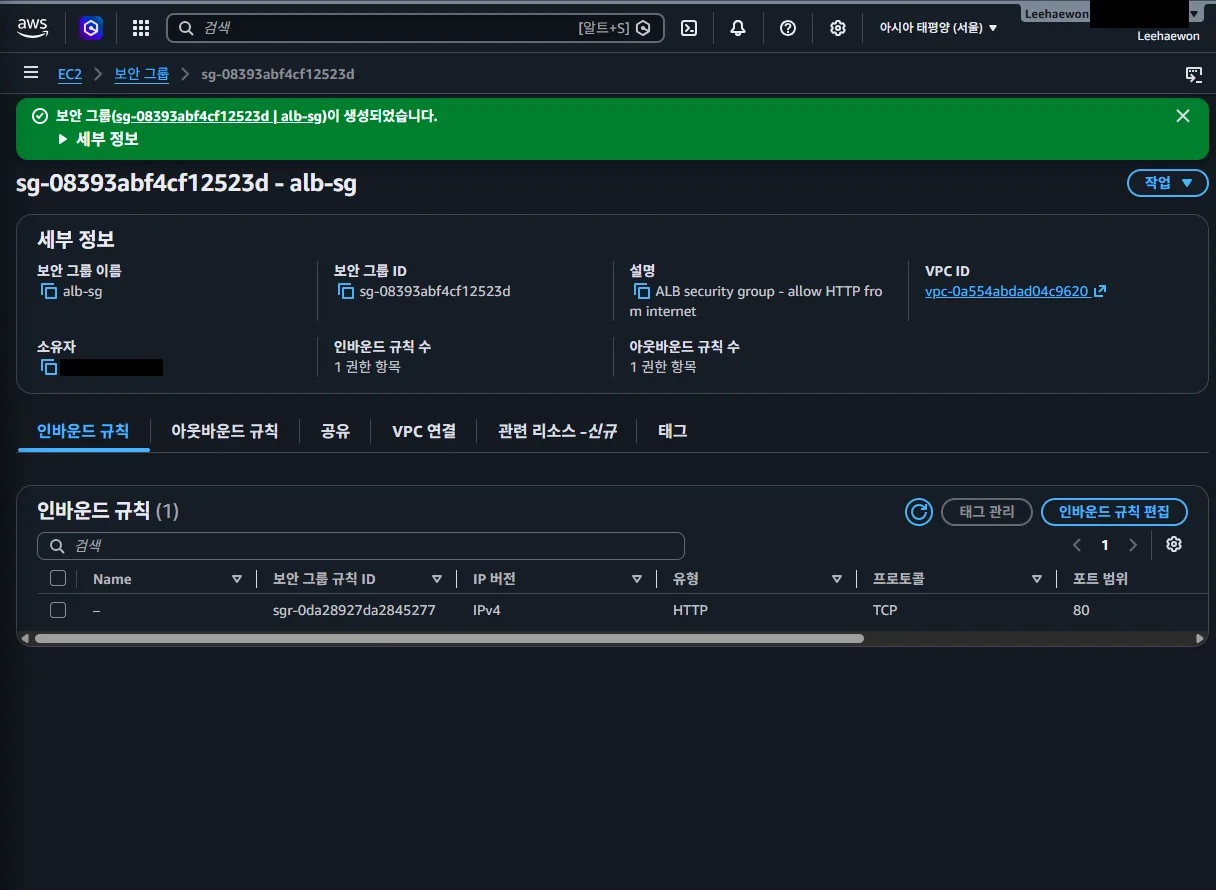
EC2 → 네트워크 및 보안 → 보안 그룹 → 보안 그룹 생성
- 이름
alb-sg - 인바운드: HTTP 80 ←
0.0.0.0/0
따로 만든 이유
ALB는 EC2와 별개의 리소스이므로 자기 방화벽이 따로 필요하다. EC2의 보안 그룹을 공유하지 않는다.
그리고 ALB는 이제 사이트 방문자를 직접 받는 입구이므로 인바운드 80을 전체(0.0.0.0/0)에 열어야 한다. 여기를 좁히면 아무도 사이트에 들어올 수 없다.
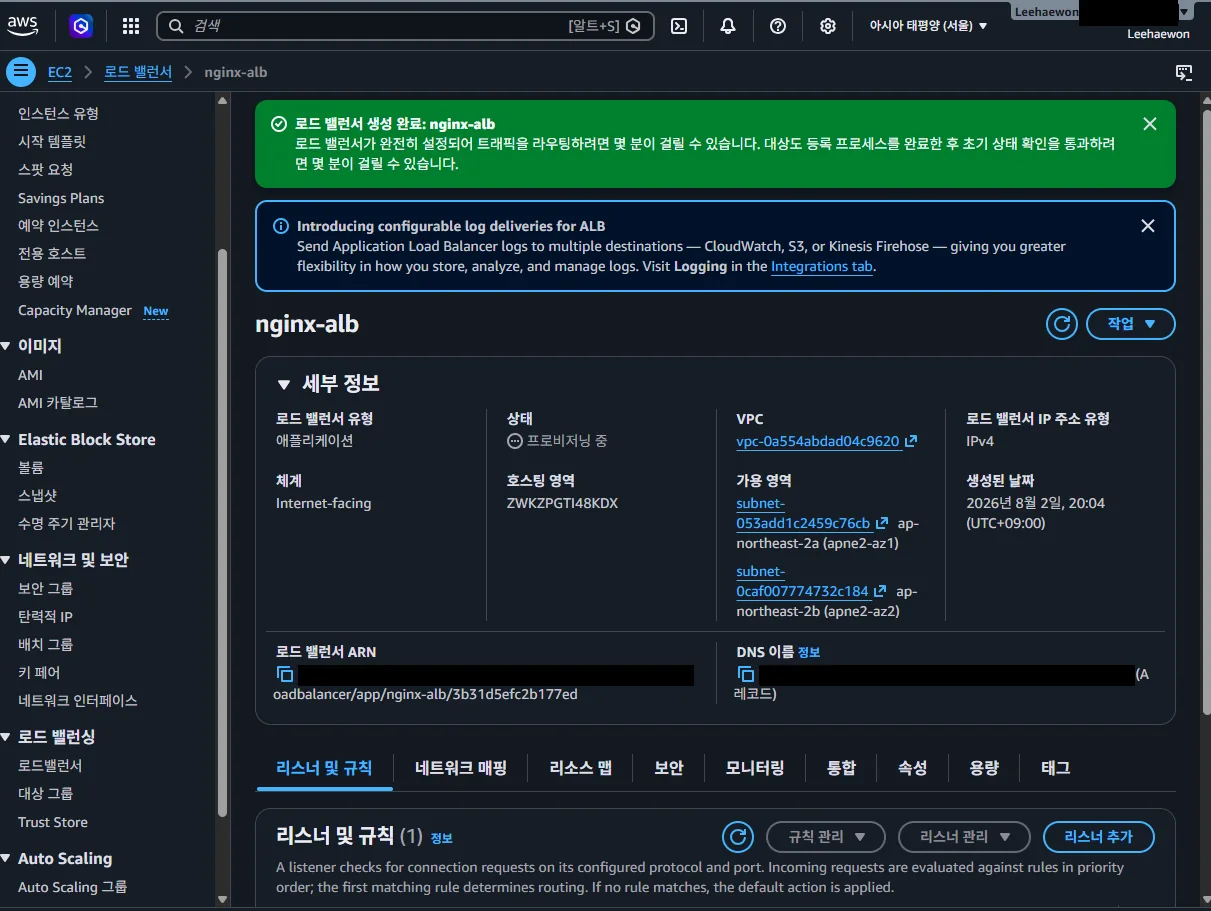
ALB 생성
EC2 → 로드 밸런싱 → 로드밸런서 → 로드 밸런서 생성
| 항목 | 설정값 | 의미 |
|---|---|---|
| 유형 | Application Load Balancer | HTTP/HTTPS 요청을 다루는 로드 밸런서 |
| 이름 | nginx-alb |
|
| 체계 | Internet-facing | 인터넷에서 접근 가능. 내부 전용이면 Internal |
| 가용 영역 | 2a, 2b |
최소 2개 필수 |
| 보안 그룹 | alb-sg |
기본 SG는 해제 |
| 리스너 | HTTP:80 → 대상 그룹 nginx-tg |
80번으로 들어온 요청을 이 명단으로 전달 |
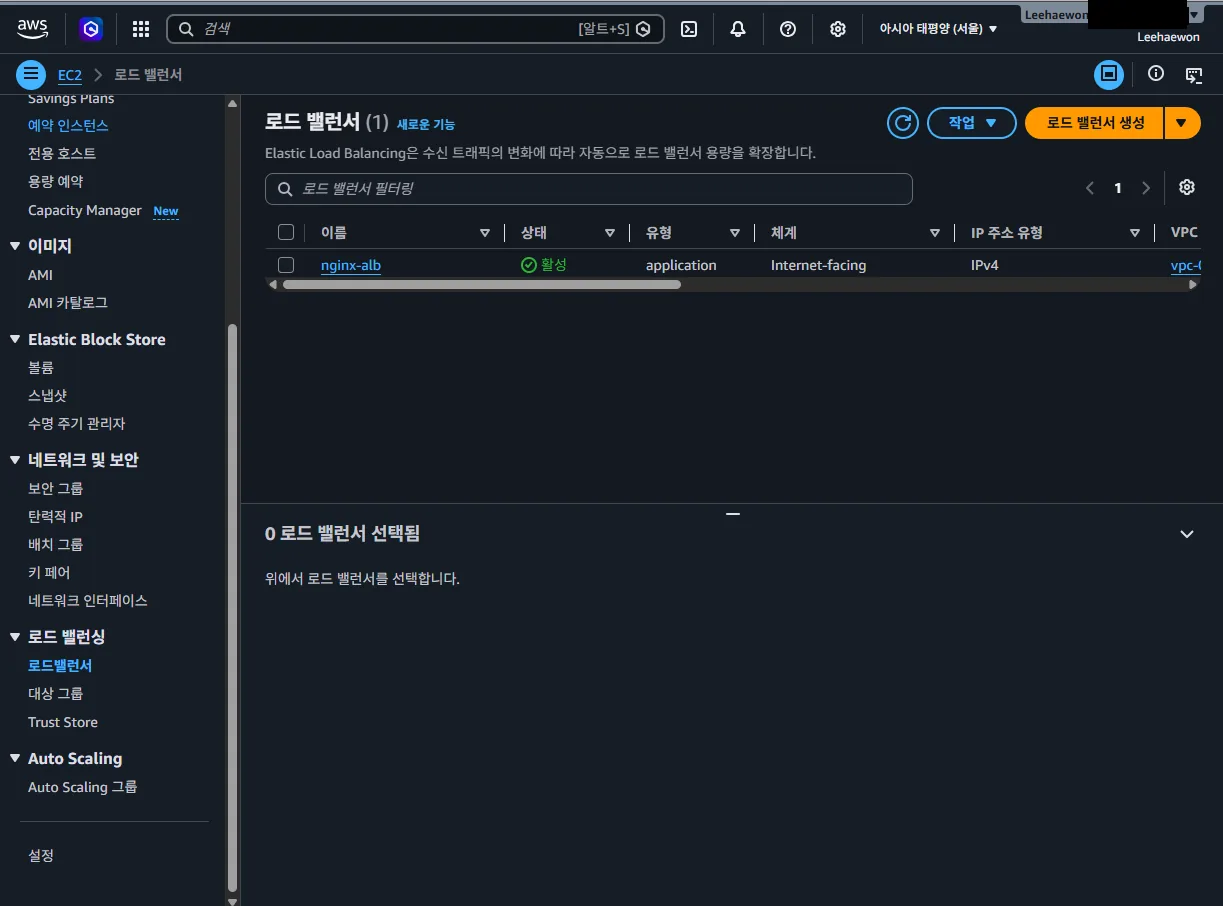
생성된 DNS 이름: <ALB DNS>
상태가 프로비저닝 중 → active로 바뀌어야 사용 가능하다.
왜 가용 영역을 2개 이상 골라야 하는가
ALB 자체도 소프트웨어이므로 어딘가에서 돌아가야 한다. 만약 ALB가 AZ 한 곳에만 있으면, 그 AZ가 죽었을 때 뒤에 서버가 아무리 많아도 입구가 사라져 서비스가 멈춘다. 즉 서버를 여러 AZ에 나누는 이유와 동일한 이유가 ALB에도 적용된다. AWS가 이를 강제하기 때문에 2개 미만으로는 생성 자체가 되지 않는다.
리스너가 하는 일
리스너는 몇 번 포트로 들어온 요청을 어디로 보낼지 정하는 규칙이다.
사용자 요청 (80번 포트)
      ↓
   리스너가 받음
      ↓
대상 그룹 nginx-tg로 전달
      ↓
명단에 있는 서버 중 한 대로
나중에 HTTPS를 붙이면 443 리스너를 추가하고, 경로에 따라 다른 대상 그룹으로 보내는 규칙(/api는 API 서버로, 나머지는 웹 서버로)도 여기서 설정한다.
EC2 보안 그룹 수정
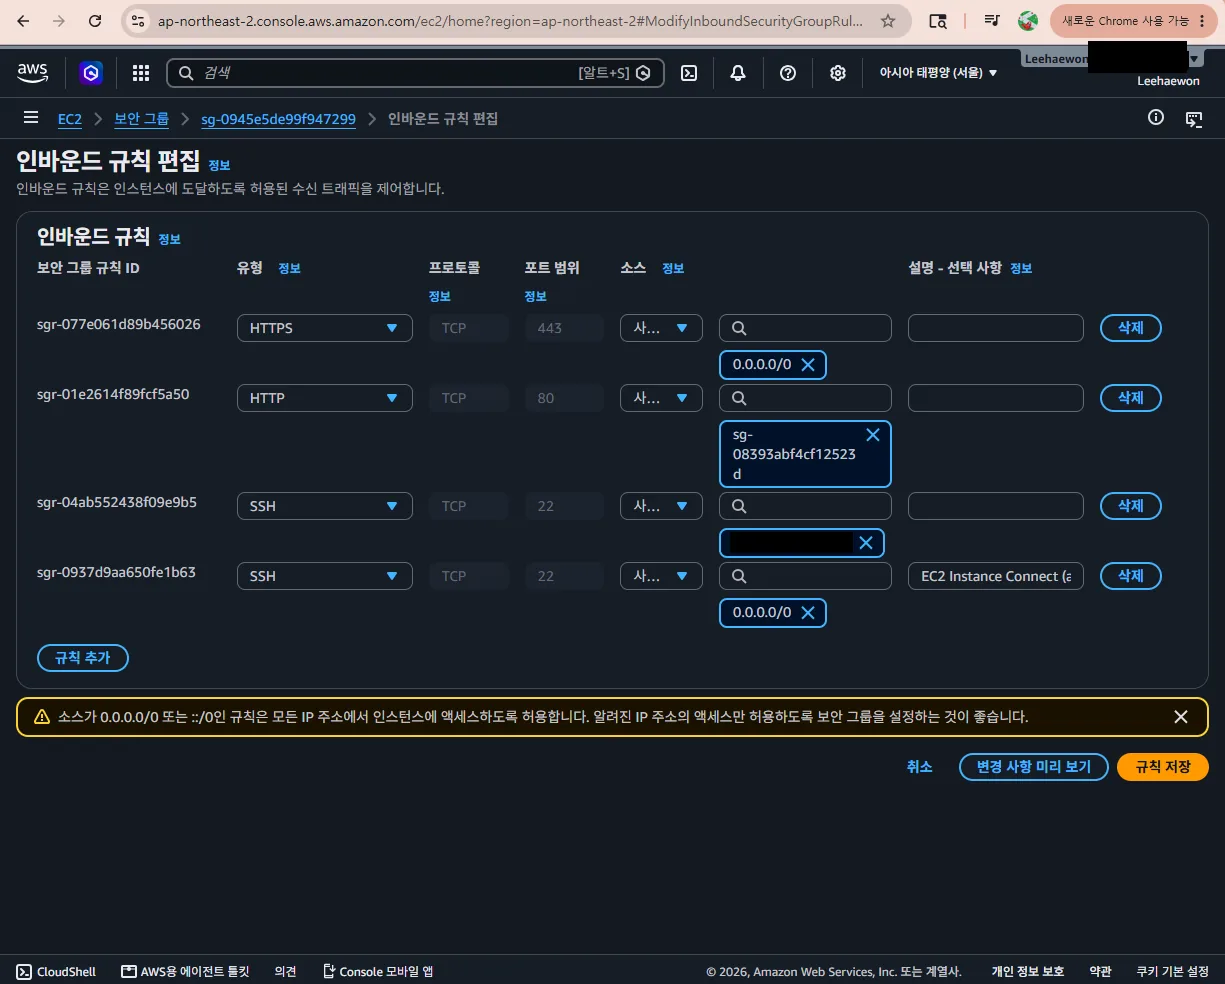
EC2 → 보안 그룹 → launch-wizard-1 → 인바운드 규칙 편집
- HTTP 80의 소스를
0.0.0.0/0→alb-sg로 변경 - SSH 22 규칙 2개(
<퍼블릭 IP>/32,<퍼블릭 IP>/29)는 유지
왜 EC2의 80번을 좁혀야 하는가
ALB를 붙이기 전에는 사용자가 EC2에 직접 접속해야 했으므로 80번이 전체에 열려 있어야 했다.
ALB를 붙인 뒤에는 모든 정상적인 요청이 ALB를 거쳐서 온다. 그런데 EC2의 80번이 여전히 전체에 열려 있으면, 누군가 EC2의 IP를 알아내 ALB를 건너뛰고 직접 접속할 수 있다. 그러면 ALB에서 하는 검사나 제어를 전부 우회하게 된다.
소스를 alb-sg로 지정하면 그 보안 그룹을 달고 있는 리소스(=ALB)에서 오는 트래픽만 통과한다.
소스에 IP가 아니라 보안 그룹을 지정하는 이유
ALB는 내부적으로 여러 IP를 사용하고, 그 IP는 AWS가 필요에 따라 바꾼다. IP로 지정하면 바뀔 때마다 규칙을 고쳐야 한다.
보안 그룹으로 지정하면 "이 그룹에 속한 것"이라는 관계로 판단하므로, IP가 바뀌든 ALB가 확장되든 규칙을 손댈 필요가 없다.
이는 4단계에서 SSH를 내 IP(<퍼블릭 IP>/32)로 제한했을 때와 대비된다. 그때는 IP가 바뀌면 규칙을 다시 고쳐야 한다는 한계가 있었다.
이 단계에서 바뀐 구조
[이전]
사용자 → EC2 퍼블릭 IP(<퍼블릭 IP>) → Nginx

[이후]
사용자 → ALB 주소 → 대상 그룹 → EC2 여러 대 → Nginx
                                    ↑
                          80번은 ALB에서 온 것만 허용
사용자는 더 이상 EC2의 IP를 알 필요도, 알 수도 없다. 따라서 4단계에서 붙인 탄력적 IP는 ALB 구조에서는 불필요해진다.
C. Launch Template · Auto Scaling Group 구성
상황
B에서 입구(ALB)와 명단(대상 그룹)까지 만들었다. 그런데 아직 명단에 올라갈 서버가 없다. 여기서 선택지가 두 가지다.
- EC2를 손으로 두 대 더 만들어서 명단에 등록한다
- 서버를 자동으로 만들고 관리하는 장치를 둔다
1번은 당장은 빠르지만, 서버가 죽었을 때 내가 직접 알아채고 다시 만들어야 한다. 새벽에 죽으면 새벽에 일어나야 한다. 2번을 택하면 그 일을 시스템이 대신한다. 그게 Auto Scaling Group이다.
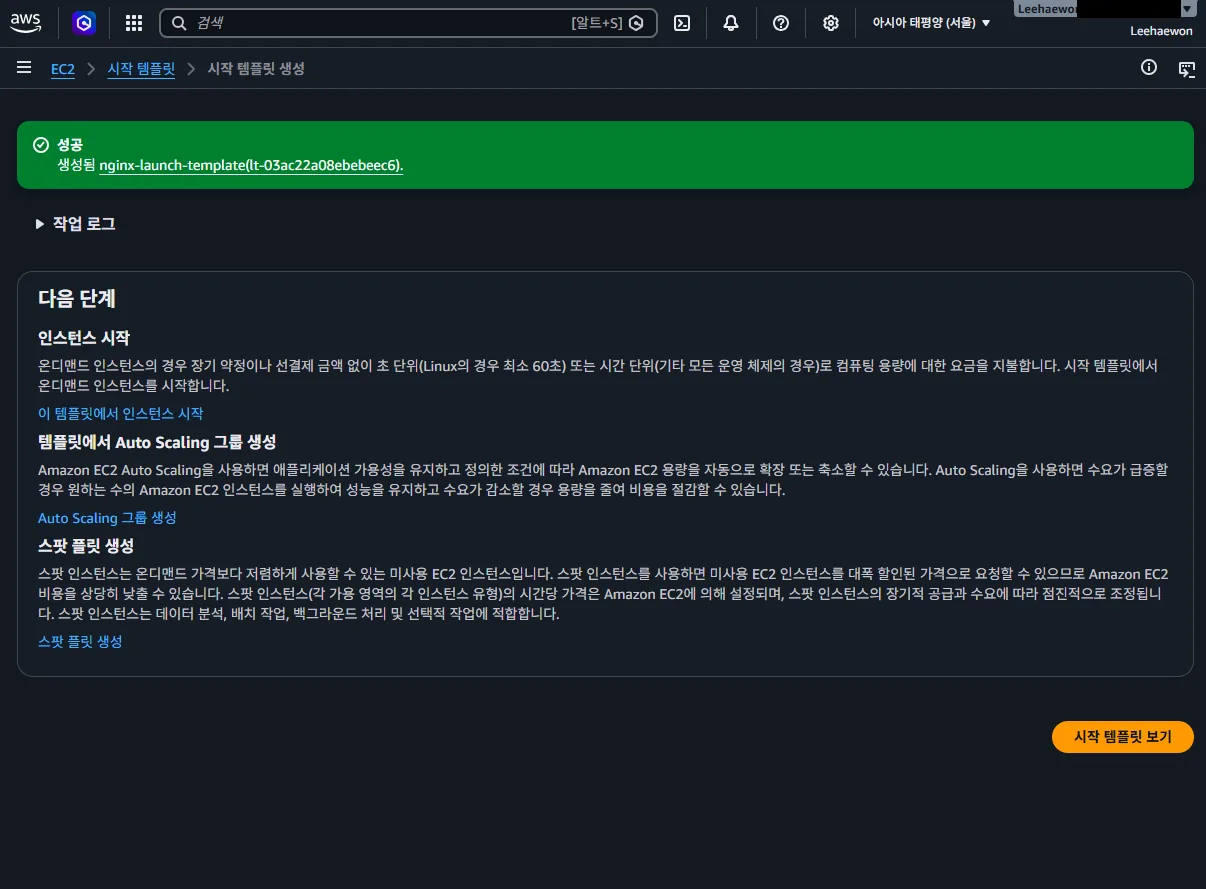
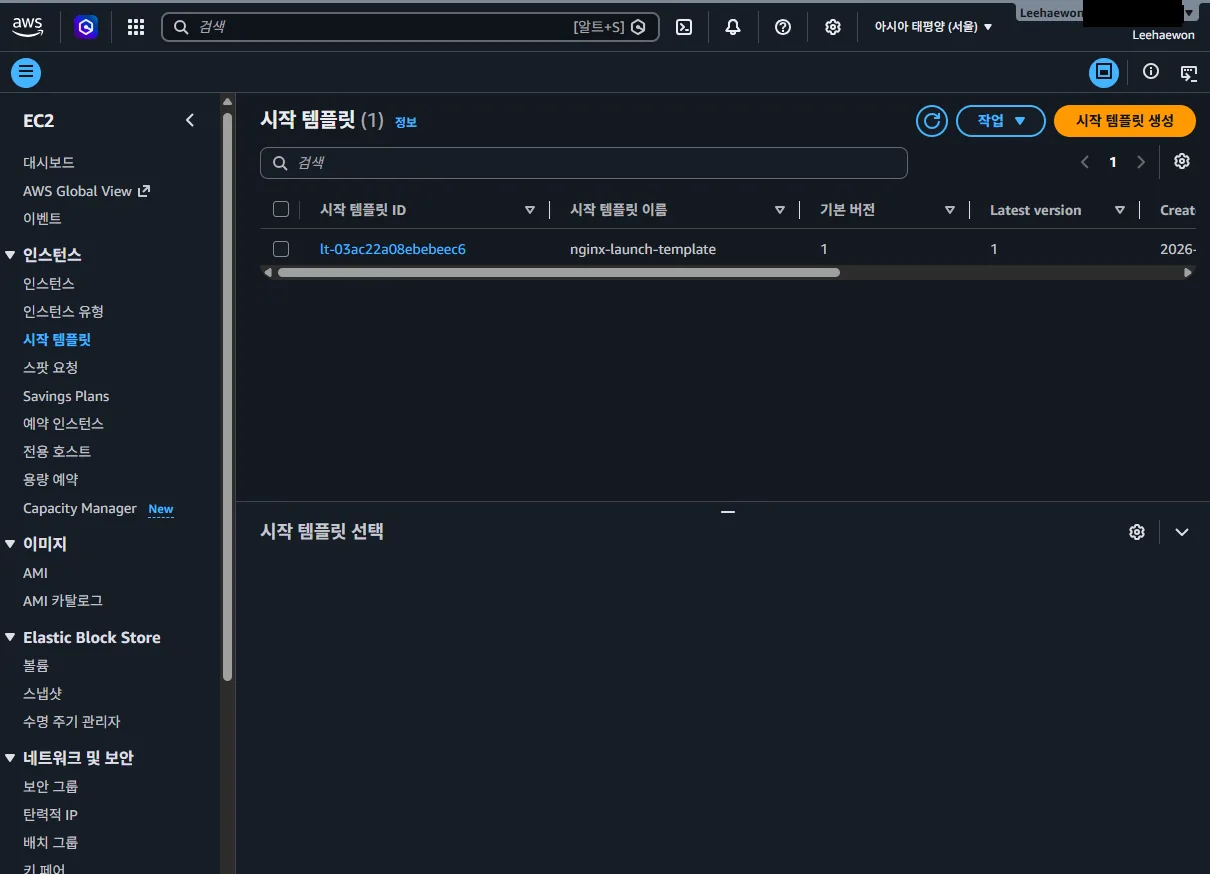
Launch Template 생성
EC2 → 인스턴스 → 시작 템플릿 → 시작 템플릿 생성
| 항목 | 설정값 |
|---|---|
| 이름 | nginx-launch-template |
| AMI | nginx-base-ami (A단계에서 만든 것) |
| 인스턴스 유형 | t3.micro |
| 키 페어 | my_first_key |
| 보안 그룹 | launch-wizard-1 |
| 서브넷 | 지정하지 않음 |
Launch Template이 필요한 이유
ASG는 "서버를 몇 대 유지할지"만 관리한다. 그런데 서버를 새로 만들려면 어떤 사양으로, 어떤 이미지로, 어떤 보안 그룹을 달고 만들지를 알아야 한다. 그 정보를 담아둔 것이 Launch Template이다.
| 구성 요소 | 역할 |
|---|---|
| Launch Template | 서버를 어떻게 만들지 정의한 설계도 |
| ASG | 그 설계도로 몇 대를 유지할지 관리하는 관리자 |
서브넷을 지정하지 않은 이유 서버를 어느 AZ에 배치할지는 ASG가 결정한다. Launch Template은 "무엇을 만들지"만 담당하고, "어디에 놓을지"는 ASG가 담당하도록 역할을 나눈 것이다.
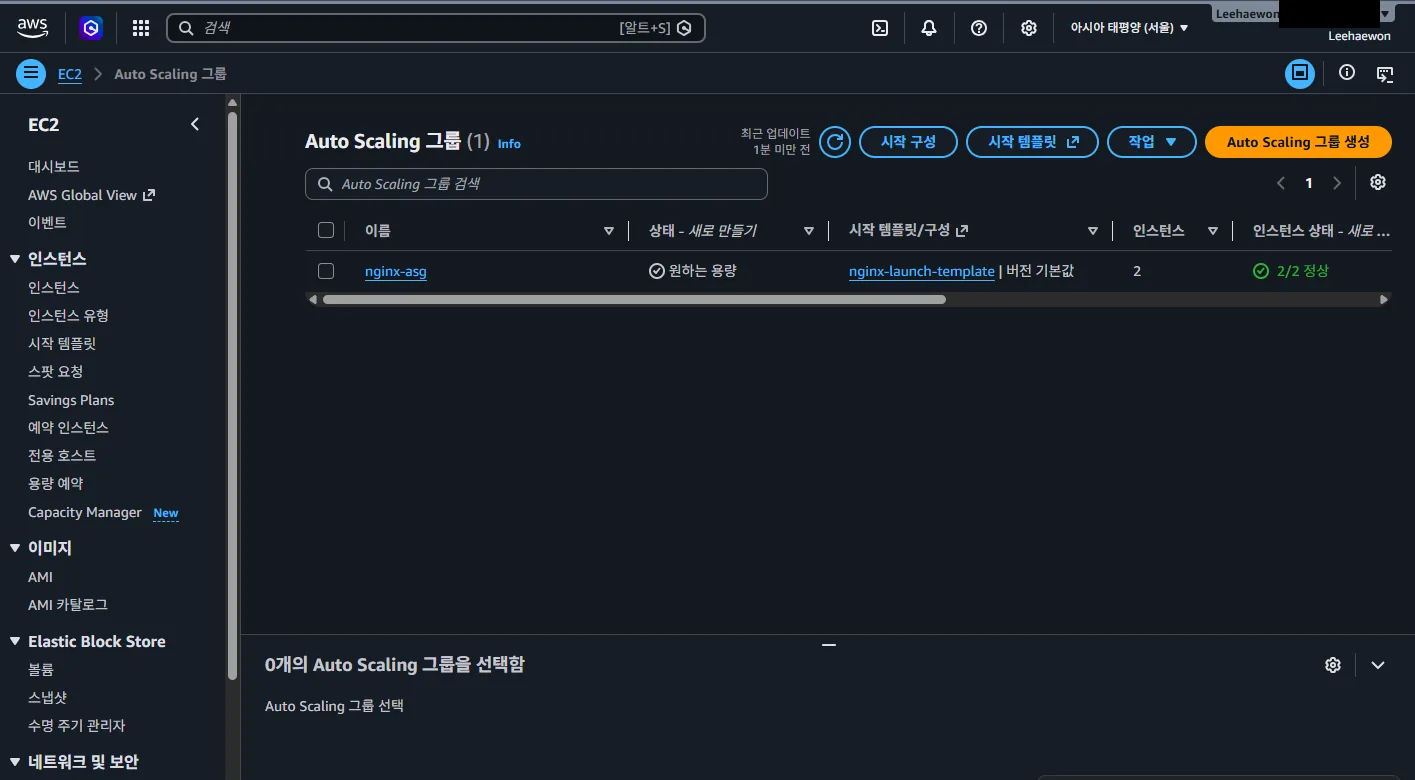
Auto Scaling Group 생성
EC2 → Auto Scaling → Auto Scaling 그룹 → Auto Scaling 그룹 생성
| 항목 | 설정값 | 의미 |
|---|---|---|
| 이름 | nginx-asg |
|
| 시작 템플릿 | nginx-launch-template |
이 설계도로 서버를 만든다 |
| 서브넷 | 2a, 2b |
ALB와 동일한 AZ여야 함 |
| 로드 밸런싱 | 대상 그룹 nginx-tg에 연결 |
만든 서버를 명단에 자동 등록 |
| 상태 검사 | ELB 상태 검사 켜기 | ALB의 판정을 ASG가 받아들임 |
| 그룹 크기 | 희망 2 / 최소 2 / 최대 4 |
희망 · 최소 · 최대의 의미
| 항목 | 의미 |
|---|---|
| 희망 용량 | 평소에 유지할 대수. 이보다 적어지면 자동으로 채운다 |
| 최소 용량 | 부하가 없어도 이 아래로는 줄이지 않는다 |
| 최대 용량 | 부하가 몰려도 이 위로는 늘리지 않는다 (비용 상한) |
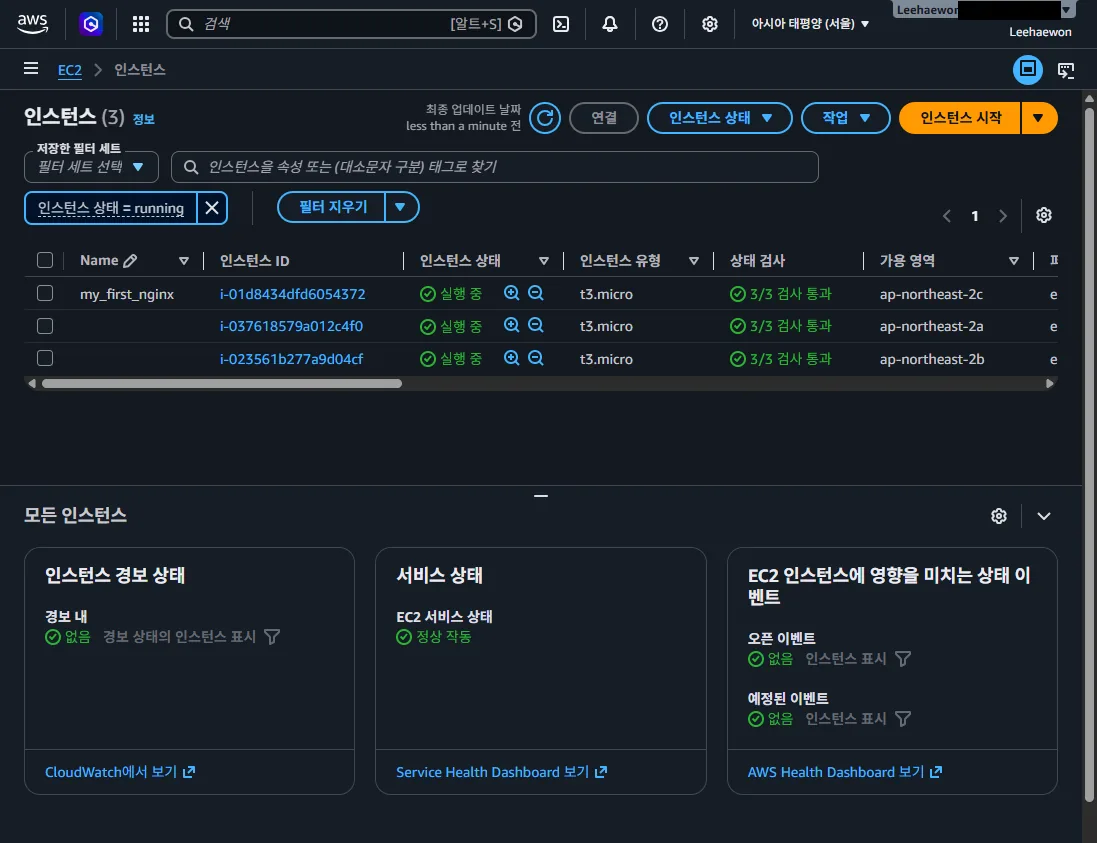
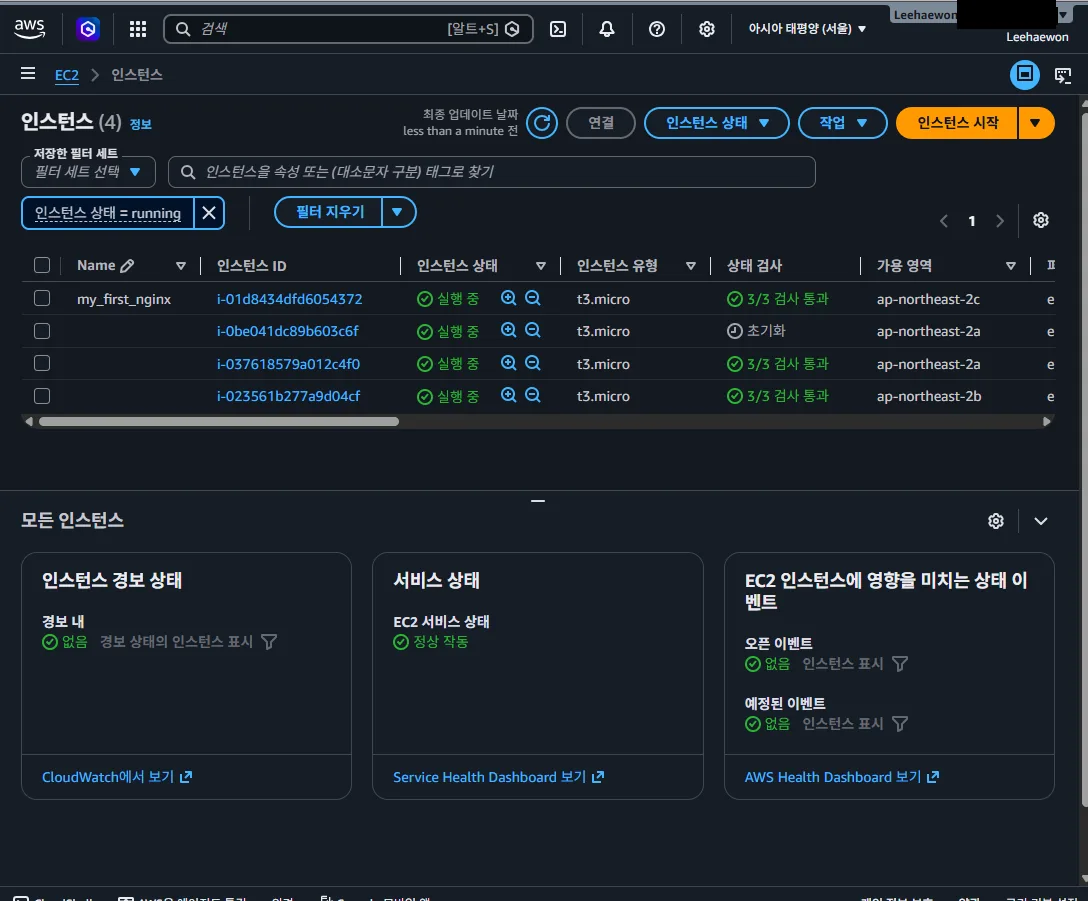
희망을 2로 둔 순간 ASG는 즉시 서버 두 대를 만들기 시작했다. 실제로 인스턴스 목록에 2a, 2b에 한 대씩 생성된 것을 확인했다.
ELB 상태 검사를 켜야 하는 이유
이 옵션이 5단계에서 가장 중요한 설정이다. 기본 상태 검사는 EC2 자체가 살아있는지만 본다. 즉 인스턴스는 켜져 있는데 그 안의 Nginx만 죽은 경우, ASG는 아무 문제가 없다고 판단한다. ELB 상태 검사를 켜면 ALB가 내린 Unhealthy 판정을 ASG가 받아들인다. 그래서 "인스턴스는 살아있지만 웹서버가 응답하지 않는" 상황에서도 서버를 교체할 수 있다.
| 설정 | 서버가 응답하지 않을 때 |
|---|---|
| EC2 상태 검사만 | ALB가 트래픽만 차단. 교체는 일어나지 않음 |
| ELB 상태 검사 켬 | ALB가 차단하고, ASG가 종료 후 새로 생성 |
D단계에서 Nginx를 중지시켰을 때 서버가 자동으로 교체된 것은 이 설정 덕분이다.
ASG가 대상 그룹에 자동 등록하는 흐름
ASG가 서버 생성
      ↓
대상 그룹 nginx-tg에 자동 등록
      ↓
ALB의 헬스체크 시작
      ↓
통과하면 Healthy → 트래픽 전달 시작
A단계에서 대상 그룹을 만들 때 인스턴스를 등록하지 않았던 이유가 여기에 있다. ASG가 서버를 만들고 없앨 때마다 명단이 자동으로 갱신되므로, 손으로 등록해두면 오히려 어긋난다.
이 단계에서 완성된 구조
ALB
 ↓
대상 그룹 (명단)
 ↑ 자동 등록
Auto Scaling Group  ← 대수 유지 · 교체
 ↑ 참조
Launch Template     ← 어떻게 만들지
 ↑ 참조
AMI                 ← 어떤 상태로 만들지
아래에서 위로 읽으면 AMI(내용물) → Launch Template(설계도) → ASG(관리자) → 대상 그룹(명단) → ALB(입구) 순서로 이어진다.
생성 결과
- 인스턴스가 자동으로 2대 생성되어
2a,2b에 각각 배치됨 - 기존
my_first_nginx(2c)를 포함해 총 3대 실행 중
D. 검증 및 리소스 정리
상황
A~C에서 구조를 다 만들었다. 이제 의도한 대로 동작하는지 확인할 차례다. 확인할 것은 두 가지다.
- 요청이 정말 여러 서버에 나뉘어 가는가
- 서버 하나가 죽어도 서비스가 유지되고, 자동으로 복구되는가
검증 ① 트래픽 분산
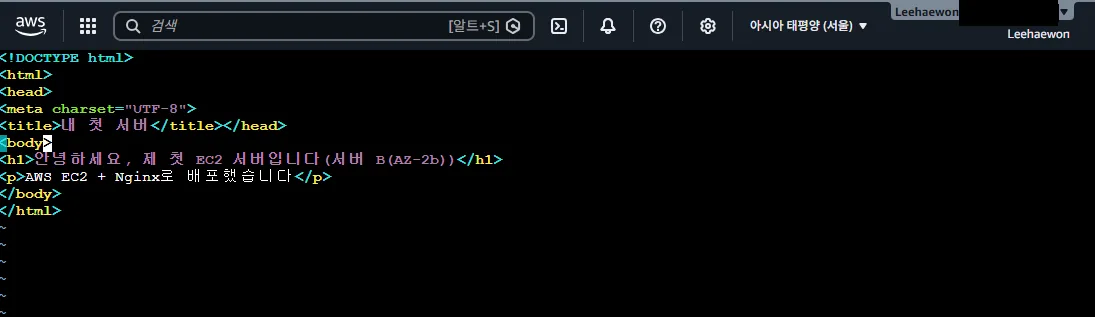
문제: ASG가 만든 두 서버는 같은 AMI로 찍어냈기 때문에 페이지 내용이 동일하다. 새로고침해도 어느 서버가 응답했는지 구분할 수 없다. 해결: 각 서버에 접속해 페이지를 다르게 수정했다.
sudo vi /usr/share/nginx/html/index.html
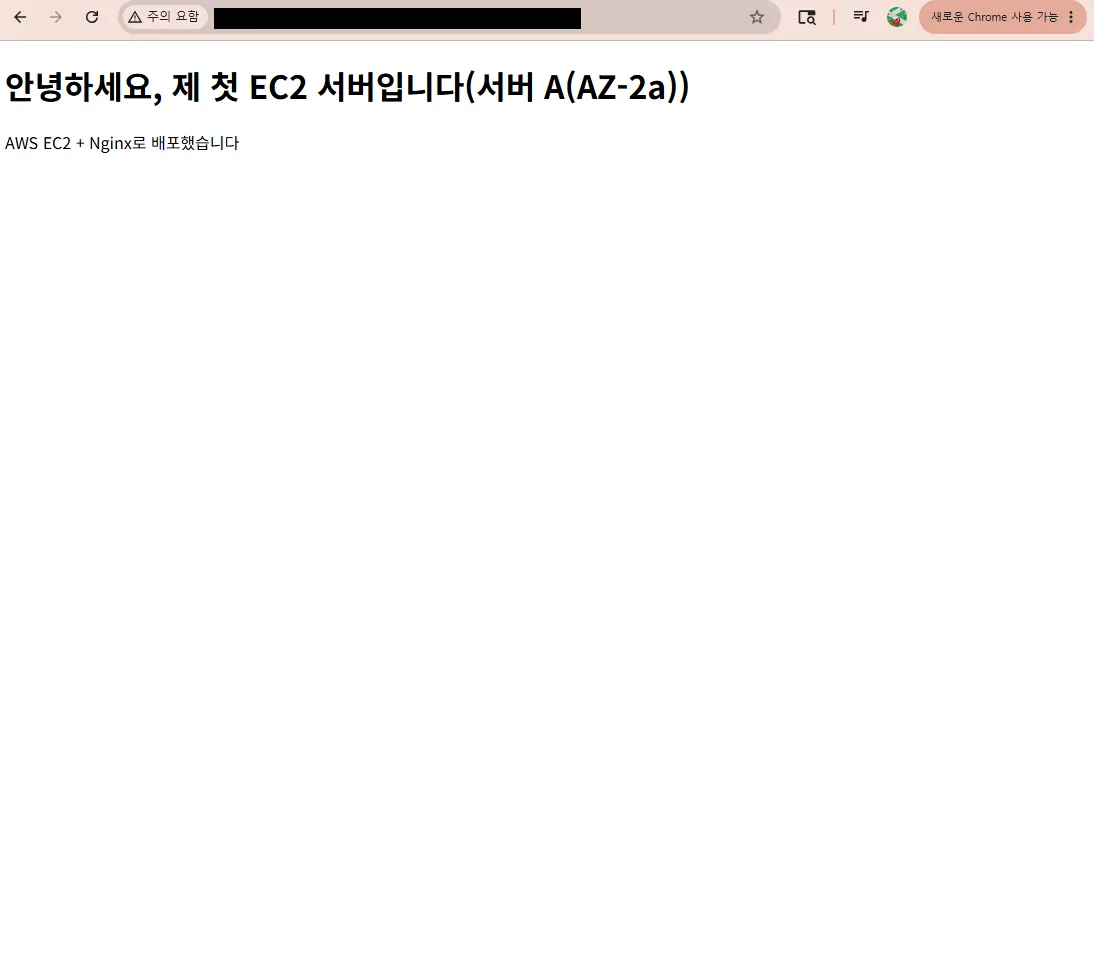
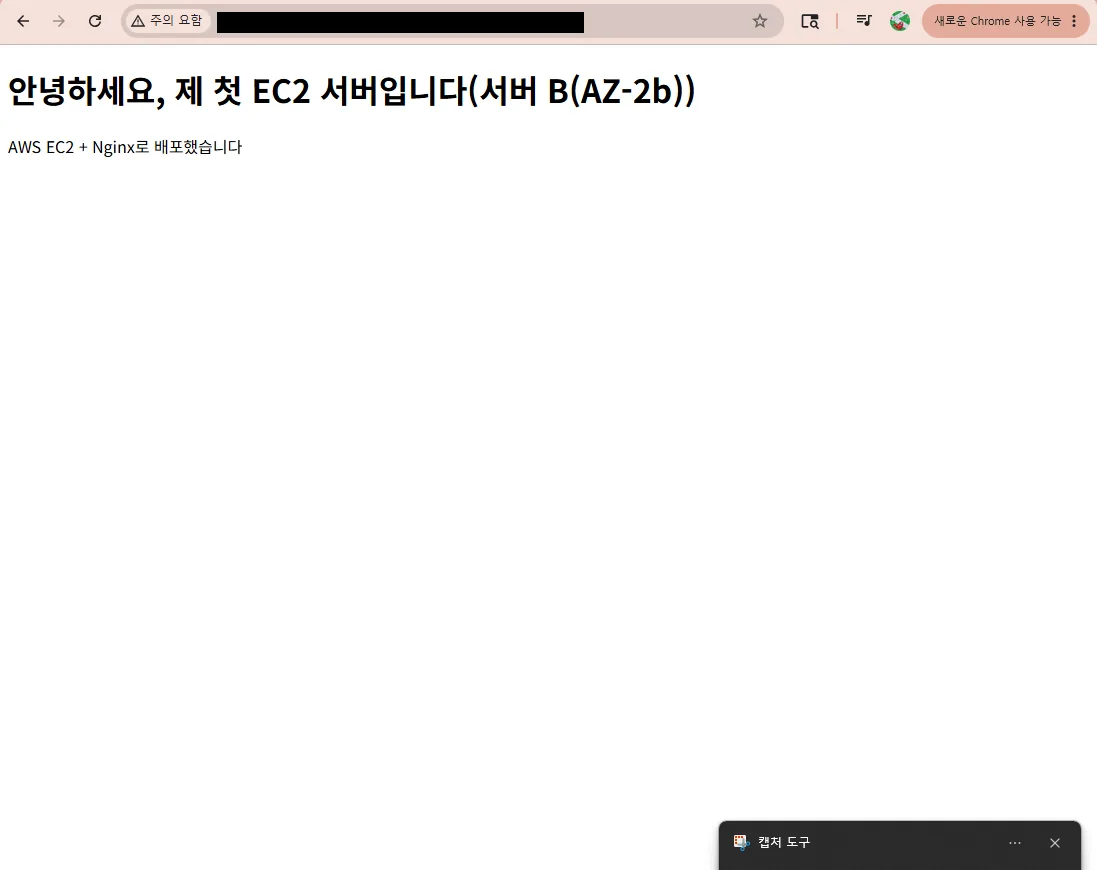
2a서버 → "서버 A(AZ-2a)"2b서버 → "서버 B(AZ-2b)"
확인: ALB 주소에서 강제 새로고침(Ctrl+Shift+R)을 반복하니 A와 B가 번갈아 표시됐다.
주소창은 계속 nginx-alb-...elb.amazonaws.com으로 동일한데 응답하는 서버만 바뀐다. 이것이 로드 밸런싱이다. 사용자는 뒤에 서버가 몇 대인지, 어느 서버가 응답했는지 알 필요가 없다.
검증 ② 장애 자동 복구
장애 발생: 서버 A의 Nginx를 중지시켰다.
sudo systemctl stop nginx
관찰된 순서
| 시점 | 상태 |
|---|---|
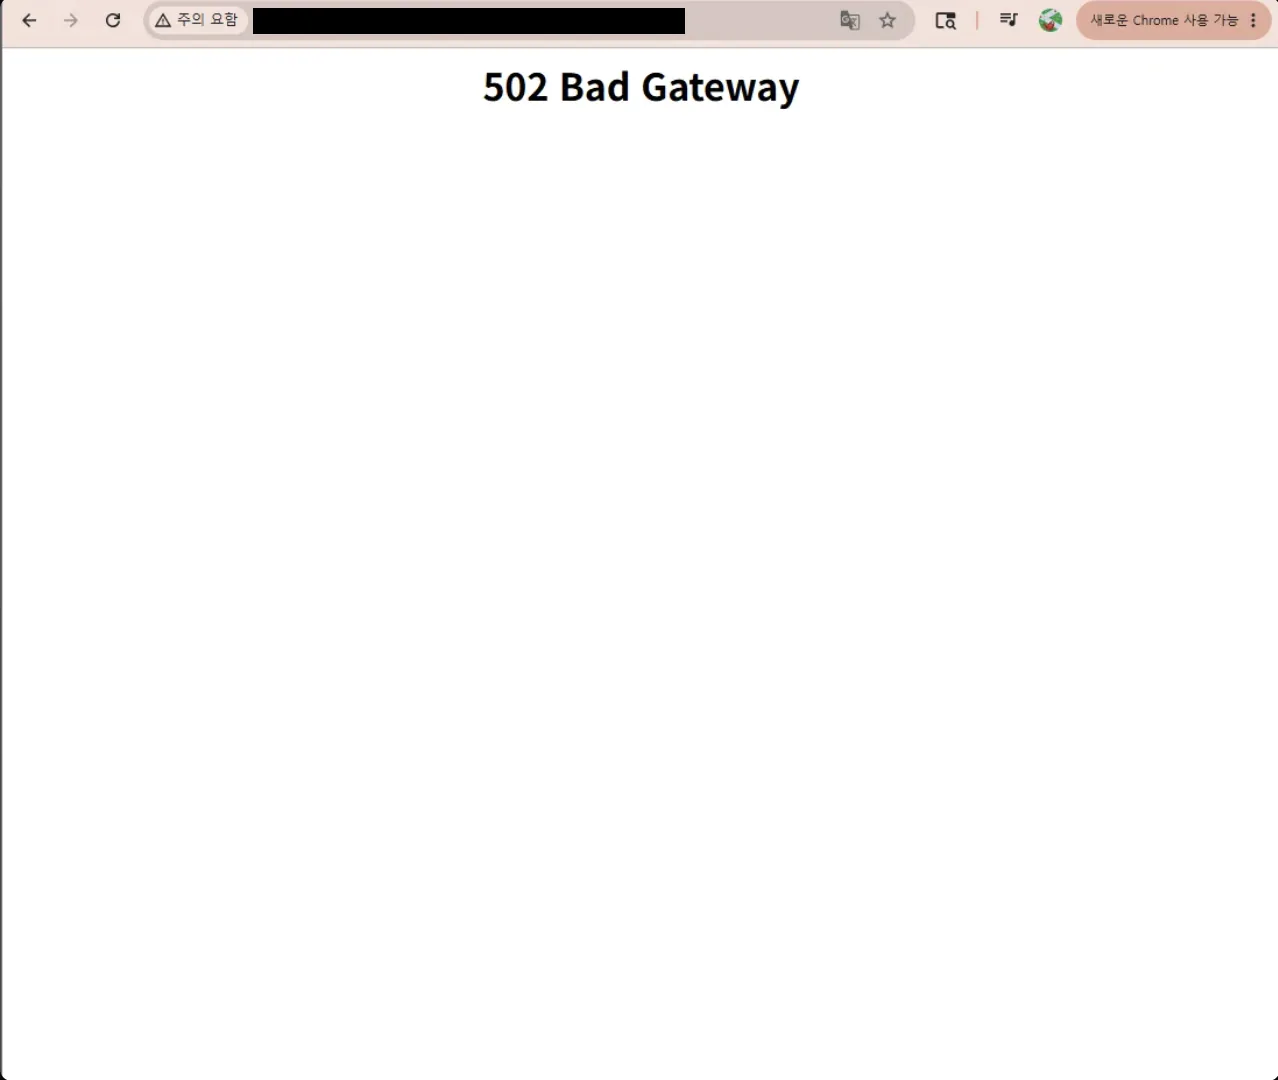
| 중지 직후 | 502와 정상 페이지가 번갈아 표시 |
| 1~2분 후 | 502가 사라지고 서버 B만 응답 |
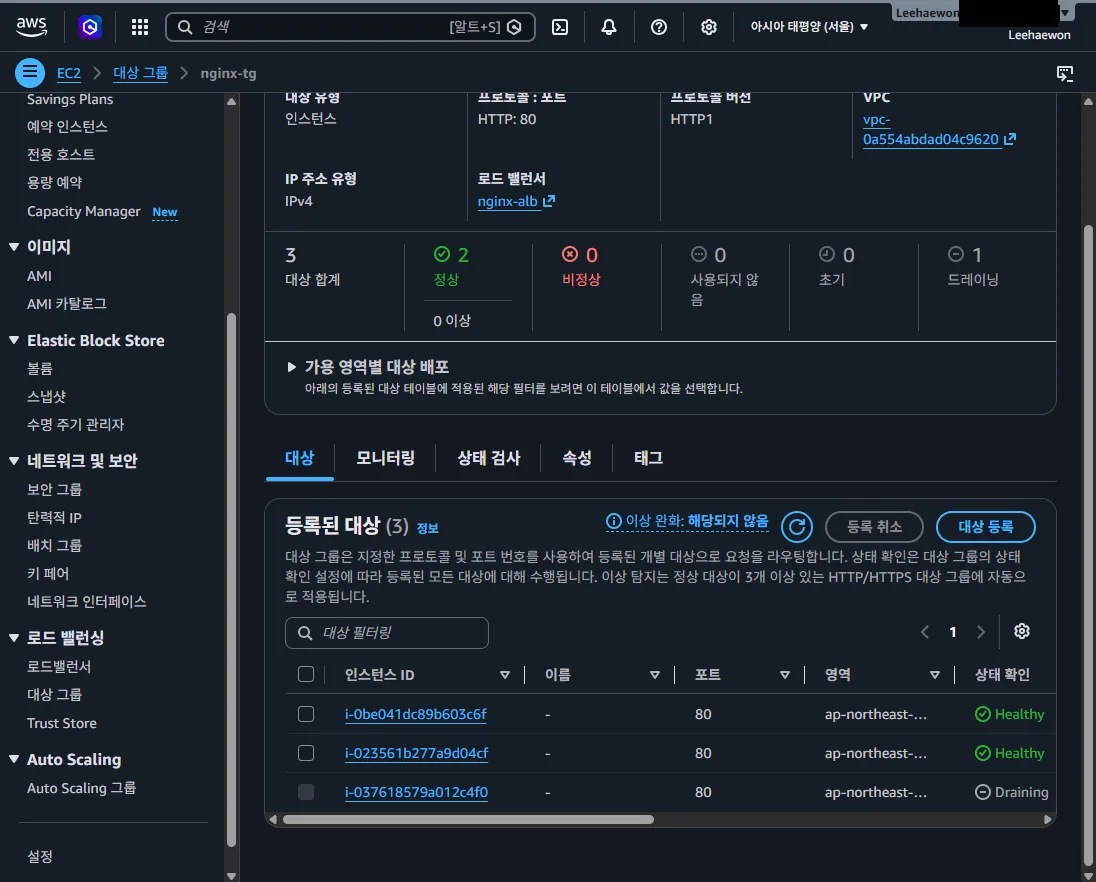
| 이후 | 대상 그룹에서 A가 Draining, 새 인스턴스가 Healthy로 합류 |
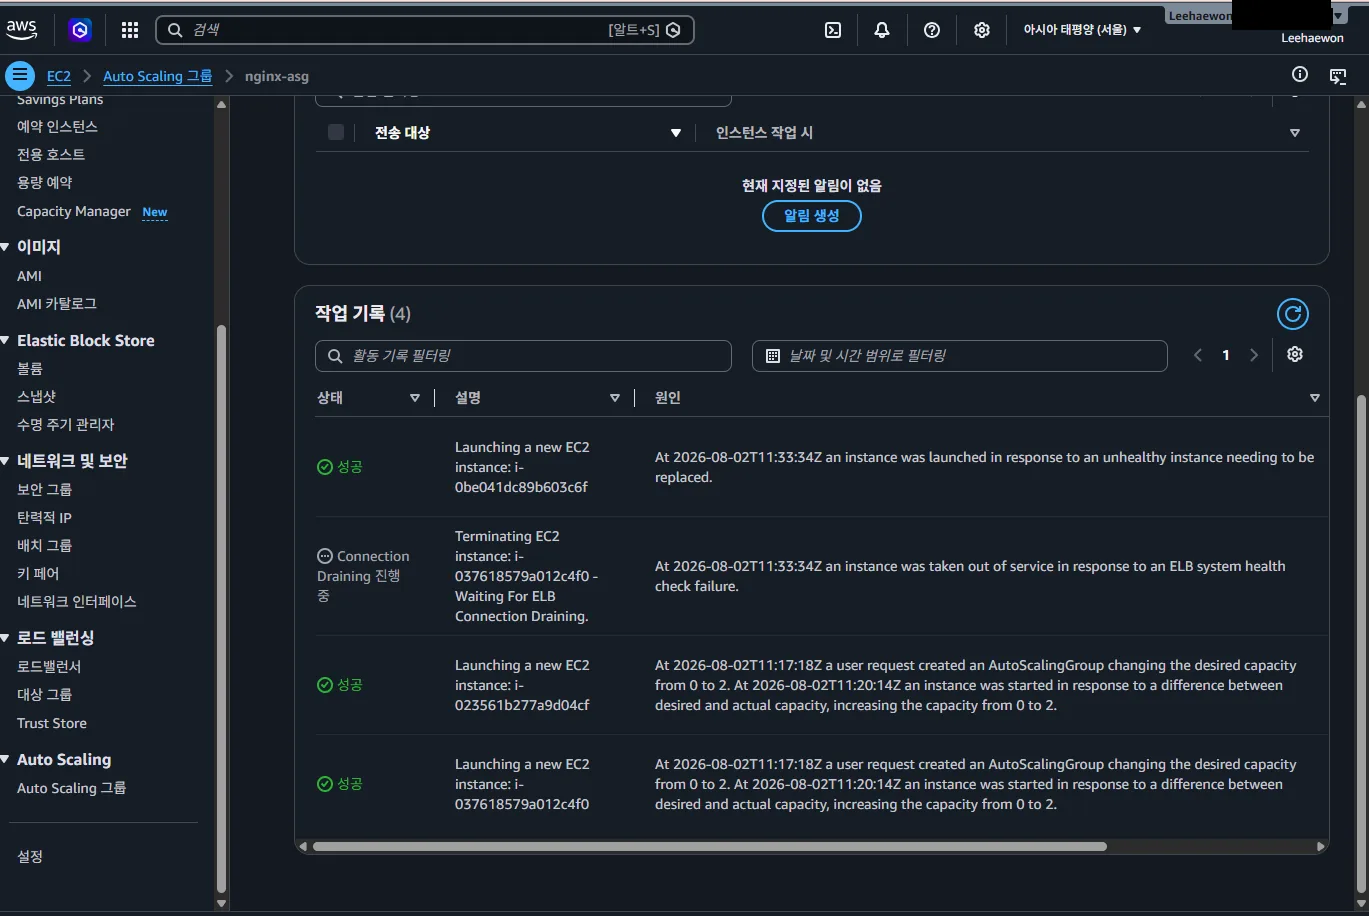
ASG 작업 기록에서 확인한 내용
Terminating EC2 instance: i-037618579a012c4f0
→ an instance was taken out of service in response to
  an ELB system health check failure

Launching a new EC2 instance: i-0be041dc89b603c6f
→ an instance was launched in response to
  an unhealthy instance needing to be replaced
AWS가 직접 "ELB 헬스체크 실패로 서비스에서 제외했고, 교체가 필요해 새 인스턴스를 생성했다"고 기록했다. 이 과정에 사람이 개입한 지점이 없다. 3단계는 장애를 사람이 진단하고 고치는 것이었다면, 5단계는 시스템이 스스로 고치는 구조를 만든 것이다.
- 대상 그룹 상태 변화 확인
- 서버 A →
Draining - 서버 B →
Healthy - 새로 생성된 인스턴스 →
Healthy
- 서버 A →
- ASG 작업 기록 확인
Terminating EC2 instance: i-037618579a012c4f0
→ an instance was taken out of service in response to an ELB system health check failure

Launching a new EC2 instance: i-0be041dc89b603c6f
→ an instance was launched in response to an unhealthy instance needing to be replaced
트러블슈팅 1 — 502와 정상 페이지가 번갈아 표시됨
증상: Nginx를 중지한 직후, 새로고침할 때마다 502 Bad Gateway와 정상 페이지가 교대로 나타남 원인: ALB의 헬스체크는 주기적으로 수행되며, 연속 실패가 누적되어야 Unhealthy로 판정한다. 판정 전까지 ALB는 중지된 서버에도 계속 트래픽을 분배했고, 그 서버가 응답하지 않으니 502를 반환한 것이다.
- 502는 "중계 장치까지는 도달했으나 뒤쪽 서버가 무응답"이라는 의미
- 3단계에서 본 TIMED_OUT(방화벽 차단), REFUSED(프로세스 없음)와 발생 지점이 다르다
해결: 별도 조치 없이 헬스체크가 Unhealthy 판정을 내린 뒤 자동으로 해소됨 재발 방지: 장애 발생과 자동 복구 사이에는 감지 지연 구간이 존재하며, 이 시간 동안 사용자는 에러를 볼 수 있다. 헬스체크 주기와 실패 임계값을 서비스 특성에 맞게 조정할 필요가 있다.
트러블슈팅 2 — 새로 생성된 서버에 수정 내용이 없음
증상: ASG가 자동 생성한 인스턴스에 접속하니, 서버 A/B 구분 문구가 없는 원본 페이지가 표시됨 원인: AMI는 문구를 수정하기 이전 시점에 생성되었다. 이후 각 서버에서 직접 수정한 내용은 AMI에 반영되지 않는다. ASG는 AMI를 그대로 복제하므로 원본 상태로 생성된다. 해결 방향
| 방법 | 내용 |
|---|---|
| User Data | 인스턴스 첫 부팅 시 실행할 스크립트를 Launch Template에 지정 |
| AMI 재생성 | 수정된 상태로 이미지를 다시 떠서 템플릿에 반영 |
| CI/CD | 코드 저장소 변경 시 자동 배포 |
재발 방지: 서버에 직접 손으로 적용한 설정은 인스턴스가 교체되면 사라진다. 반복 가능한 배포 수단을 통해 적용해야 한다. 이것이 다음 단계에서 인프라를 코드로 관리해야 하는 이유다.
리소스 정리
실습 후 비용 발생을 막기 위해 아래 순서로 삭제했다.
| 순서 | 대상 | 이유 |
|---|---|---|
| 1 | ASG | 먼저 지우지 않으면 인스턴스를 계속 재생성함 |
| 2 | ALB | 실행만으로 시간당 과금 |
| 3 | 대상 그룹 | |
| 4 | ASG 생성 인스턴스 | ASG 삭제 시 자동 종료됨 |
| 5 | my_first_nginx |
중지만 (삭제 아님, 다음 단계에서 사용) |
순서가 중요한 이유: ASG를 남겨둔 채 인스턴스만 종료하면, ASG가 희망 용량을 맞추기 위해 즉시 새 인스턴스를 만든다. 반드시 ASG를 먼저 제거해야 한다.
5단계 용어
5단계에서 처음 나온 개념. A → D 진행 순서대로 정리했다.
A. AMI 생성 및 대상 그룹 준비
| 용어 | 한 줄 설명 |
|---|---|
| 대상 그룹 (Target Group) | ALB가 트래픽을 보낼 서버들의 목록. 헬스체크도 이 단위로 수행된다 |
| 헬스체크 (상태 검사) | 주기적으로 서버에 요청을 보내 정상 응답 여부를 확인하는 것 |
| Healthy / Unhealthy | 헬스체크 통과 여부. unhealthy면 트래픽을 보내지 않는다 |
대상 그룹과 ALB를 분리하는 것은 관심사 분리다. ALB는 분배를 맡고, 대상 그룹은 목록과 상태 관리를 맡는다.
B. ALB 생성
| 용어 | 한 줄 설명 |
|---|---|
| ALB (Application Load Balancer) | 들어온 요청을 여러 서버에 나눠 보내는 로드밸런서 |
| 리스너 (Listener) | ALB가 몇 번 포트로 들어온 요청을 어느 대상 그룹으로 보낼지 정하는 규칙 |
| ALB DNS 이름 | ALB 생성 시 부여되는 접속 주소. 사용자는 개별 EC2의 IP가 아니라 이 주소로 접속한다 |
ALB는 최소 2개 가용 영역에 배치해야 한다. 한 AZ 전체가 장애를 겪어도 다른 AZ에서 서비스가 계속되도록 하기 위해서다.
C. Launch Template과 ASG
| 용어 | 한 줄 설명 |
|---|---|
| Launch Template (시작 템플릿) | ASG가 새 서버를 띄울 때 사용하는 설계도. AMI·인스턴스 유형·보안 그룹 등을 정의 |
| ASG (Auto Scaling Group) | 지정한 대수를 유지하며 인스턴스를 자동으로 생성·교체·증감시키는 그룹 |
| 희망 / 최소 / 최대 용량 | ASG가 유지할 인스턴스 대수 설정값 |
| User Data | 인스턴스가 처음 부팅될 때 자동 실행되는 스크립트. 초기 설정 자동화에 사용 |
Launch Template은 설계도이고 ASG는 그 설계도로 몇 대를 유지할지 관리하는 주체다. 인스턴스 수는 서브넷 개수가 아니라 희망 용량(desired capacity) 으로 결정된다.
D. 자동 복구 검증
| 용어 | 한 줄 설명 |
|---|---|
| 502 Bad Gateway | 로드밸런서가 뒤쪽 서버로부터 정상 응답을 받지 못했을 때 반환하는 응답 |
| Draining | 처리 중인 요청만 마무리하고 대상 그룹에서 빠지는 상태. 갑작스러운 연결 끊김을 방지 |
| 고가용성 (High Availability) | 일부 구성 요소가 실패해도 서비스가 계속 동작하도록 만든 구조 |
| 단일 장애점 (SPOF) | 그 하나가 멈추면 전체 서비스가 멈추는 지점. 서버 1대·AZ 1곳 구성이 여기에 해당 |
AMI의 한계
ASG가 새로 만드는 인스턴스는 AMI 생성 이후의 수동 변경사항을 반영하지 않는다. 서버에 직접 접속해 파일을 고쳐도 그 변경은 AMI에 포함되지 않으므로 새 서버에는 적용되지 않는다. 이것이 Terraform 같은 IaC 도구를 도입하는 직접적인 이유다.
배운 점
직접 작성-
A : AMI / 대상 그룹
- AMI : 지금 돌아가는 서버의 이미지를 따둔 상태. 이 이미지로 찍어낸 서버는 Nginx가 이미 설치된 상태로 생성
- 서버를 여러 대로 늘려야 하는데, 매번 EC2 만들고 Nginx 설치하는 걸 반복할 수 없어서 지금 상태를 통째로 이미지로 떠뒀다.
- 그룹 대상 : ALB가 트랙픽을 보낼 서버 명단
- 요청을 어떤 서버들에게, 몇 번 포트로 보내고 , 살아있는지 어떻게 확인할 것인가
- ALB가 EC2에 바로 보내지않고 그룹대상을 걸치고 보낸다.
- 대상 그룹을 만들 때 인스턴스를 직접 등록하지 않았다. ASG가 서버를 만들고 없앨 때마다 명단을 자동으로 갱신하기 때문에, 손으로 등록하면 오히려 어긋난다.
- 상태 검사 경로를
/로 지정. ALB가 주기적으로 이 경로로 요청을 보내 서버가 살아있는지 확인한다.
- AMI : 지금 돌아가는 서버의 이미지를 따둔 상태. 이 이미지로 찍어낸 서버는 Nginx가 이미 설치된 상태로 생성
-
B : ALB 구성 및 보안 그룹 재설정
- ALB (Application Load Balancer) : 하나의 주소로 들어온 HTTP 요청을 여러 서버에 나눠서 전달하는 AWS의 로드 밸런서
- Application : 애플리케이션 계층(HTTP/HTTPS)의 내용을 이해하고 처리한다는 뜻
- Load Balancer : 부하(Load)를 여러 서버에 고르게 나누는(Balance) 장치
- ALB의 보안그룹 : EC2와 공유하지 않으므로 따로 생성
- ALB의 가용영역 : 2개 이상 설정
- ALB가 AZ 한 곳에만 있으면, 그 AZ가 죽었을 때 뒤에 서버가 아무리 많아도 입구가 사라져 서비스가 멈춘다.
- 리스너 : 몇 번 포트로 들어온 요청을 어디로 보낼지 정하는 규칙
- 사용자 요청 (port : 80) —> 리스너 → 그룹 대상 (nginx-tg)
- EC2의 보안그룹 재설정
- HTTP 인바운드 설정을 ALB로 수정
- 전에는 사용자가 EC2에 직접 접속해야 했기 때문에 80번을 전체에 열어둘 수밖에 없었지만, ALB를 붙인 뒤에는 모든 정상 요청이 ALB를 거쳐 오므로 소스를 ALB 보안 그룹으로 변경
- EC2의 80번이 여전히 전체에 열려 있으면, 누군가 EC2의 IP를 알아내 ALB를 건너뛰고 직접 접속할 수 있다. 그러면 ALB에서 하는 검사나 제어를 전부 우회하게 된다.
- 소스에 IP가 아니라 보안 그룹을 지정한 이유
- ALB는 내부적으로 여러 IP를 쓰고 AWS가 바꾼다. IP로 지정하면 바뀔 때마다 고쳐야 하지만, 보안 그룹으로 지정하면 "이 그룹에 속한 것"이라는 관계로 판단하므로 손댈 필요가 없다.
- HTTP 인바운드 설정을 ALB로 수정
- ALB (Application Load Balancer) : 하나의 주소로 들어온 HTTP 요청을 여러 서버에 나눠서 전달하는 AWS의 로드 밸런서
-
C : Launch Template · Auto Scaling Group 구성
- Launch Template : EC2 인스턴스를 만들 때 사용할 설정을 미리 정의해둔 설계도.
- 새 서버를 만들려면 결정해야 하는 것들을 미리 적어두는 것 (AMI, 인스턴스 유형, 키페어, 보안그룹)
- 무엇을 만들지만 정의, 서버를 어디에 둘 것은 ASG가 정의
- ASG : Auto Scaling Group
-
지정한 대수를 유지하도록 인스턴스를 자동으로 만들고, 없애고, 교체하는 그룹
-
지정된 서브넷들에 최대한 고르게 나눠서 배치
- 희망 용량 : 평소에 유지할 대수. 이보다 적어지면 자동으로 채운다
- 최소 용량 : 부하가 없어도 이 아래로는 줄이지 않는다
- 최대 용량 : 부하가 몰려도 이 위로는 늘리지 않는다 (비용 상한)
희망 용량 서브넷 결과 2 2a, 2b 각 AZ에 1대씩 4 2a, 2b 각 AZ에 2대씩 1 2a, 2b 둘 중 한 곳에 1대만 2 2a만 2a에 2대 몰림 -
ELB 상태검사
- ALB가 내린 Unhealthy 판정을 ASG가 받아들인다**.** 그래서 "인스턴스는 살아있지만 웹서버가 응답하지 않는" 상황에서도 서버를 교체할 수 있다.
-
- [요청 흐름] 사용자 → ALB → 대상 그룹 ─┐
├→ EC2
[생성 흐름] AMI → Launch Template → ASG ┘
- Launch Template : EC2 인스턴스를 만들 때 사용할 설정을 미리 정의해둔 설계도.
-
D : 검증 및 리소스 정리
- 트래픽 분산 : 2a, 2b 서버에 각각 index.html을 다르게 입력 후 웹페이지 새로고침하면서 확인 —> 변갈아가면서 바뀐 내용들 나오는 거 확인
- 장애 자동 복구 : 2a 서버 중지시킴 → 502 오류 페이지랑 2b 서버 페이지 두 개가 번갈아가면서 나오다가 최종적으로 2b 서버 index.html만 나옴.
- ALB의 헬스체크는 주기적으로 하고 연속 실패가 쌓여야 Unhealthy 판정을 내린다.
- 판정 전까지는 죽은 서버에도 계속 트래픽을 보내서 502가 났고, 판정 후 제외되면서 사라졌다.
- 대상그룹의 변화
- 2a 서버 →
Draining(처리 중인 요청만 마무리하고 명단에서 빠지는 중) - ASG가 새로 만든 서버 → 헬스체크 통과 후
Healthy로 명단에 합류
- 2a 서버 →
- ASG가 새로 만든 서버에는 서버 A/B (다르게 입력한 구문) 구분 문구가 없었다.
- AMI가 문구 수정 이전에 만들어졌기 때문. 서버에 손으로 고친 건 인스턴스가 교체되면 사라진다.
- ALB의 헬스체크는 주기적으로 하고 연속 실패가 쌓여야 Unhealthy 판정을 내린다.