목표
8단계에서 배포한 ECS 서비스의 로그와 지표를 CloudWatch에서 확인하고, 이상 상황을 이메일로 통보받는 경로를 구성한다. 알람은 설정에서 끝내지 않고 실제로 발생시켜 수신까지 검증한다.
인프라는 8단계 구성을 그대로 사용했다. 시간당 과금 리소스가 있으므로 8단계 배포·검증과 같은 날 이어서 진행하고 마지막에 함께 삭제했다.
A. CloudWatch 로그 확인과 알람 구성
목표
8단계에서 배포한 ECS 서비스의 로그를 CloudWatch에서 확인하고, 이상 상황을 이메일로 통보받는 경로를 구성한다. 알람은 설정에서 끝내지 않고 실제로 발생시켜 수신까지 검증한다.
1. 컨테이너 로그는 어디로 가는가
로그 설정은 8단계 ecs.tf의 태스크 정의에 이미 들어 있었다.
logConfiguration = {
  logDriver = "awslogs"
  options = {
    "awslogs-group"         = "/ecs/tf-step8-myweb"
    "awslogs-region"        = "ap-northeast-2"
    "awslogs-stream-prefix" = "ecs"
  }
}
EC2였다면 SSH로 들어가 /var/log/nginx/access.log를 봤을 것이다. 그러나 컨테이너는 SSH로 들어갈 수 없고, 컨테이너를 지우면 안에 있던 로그도 함께 사라진다. 그래서 로그를 컨테이너 밖으로 내보내는 설정이 필수이며, awslogs 드라이버가 그 역할을 한다.
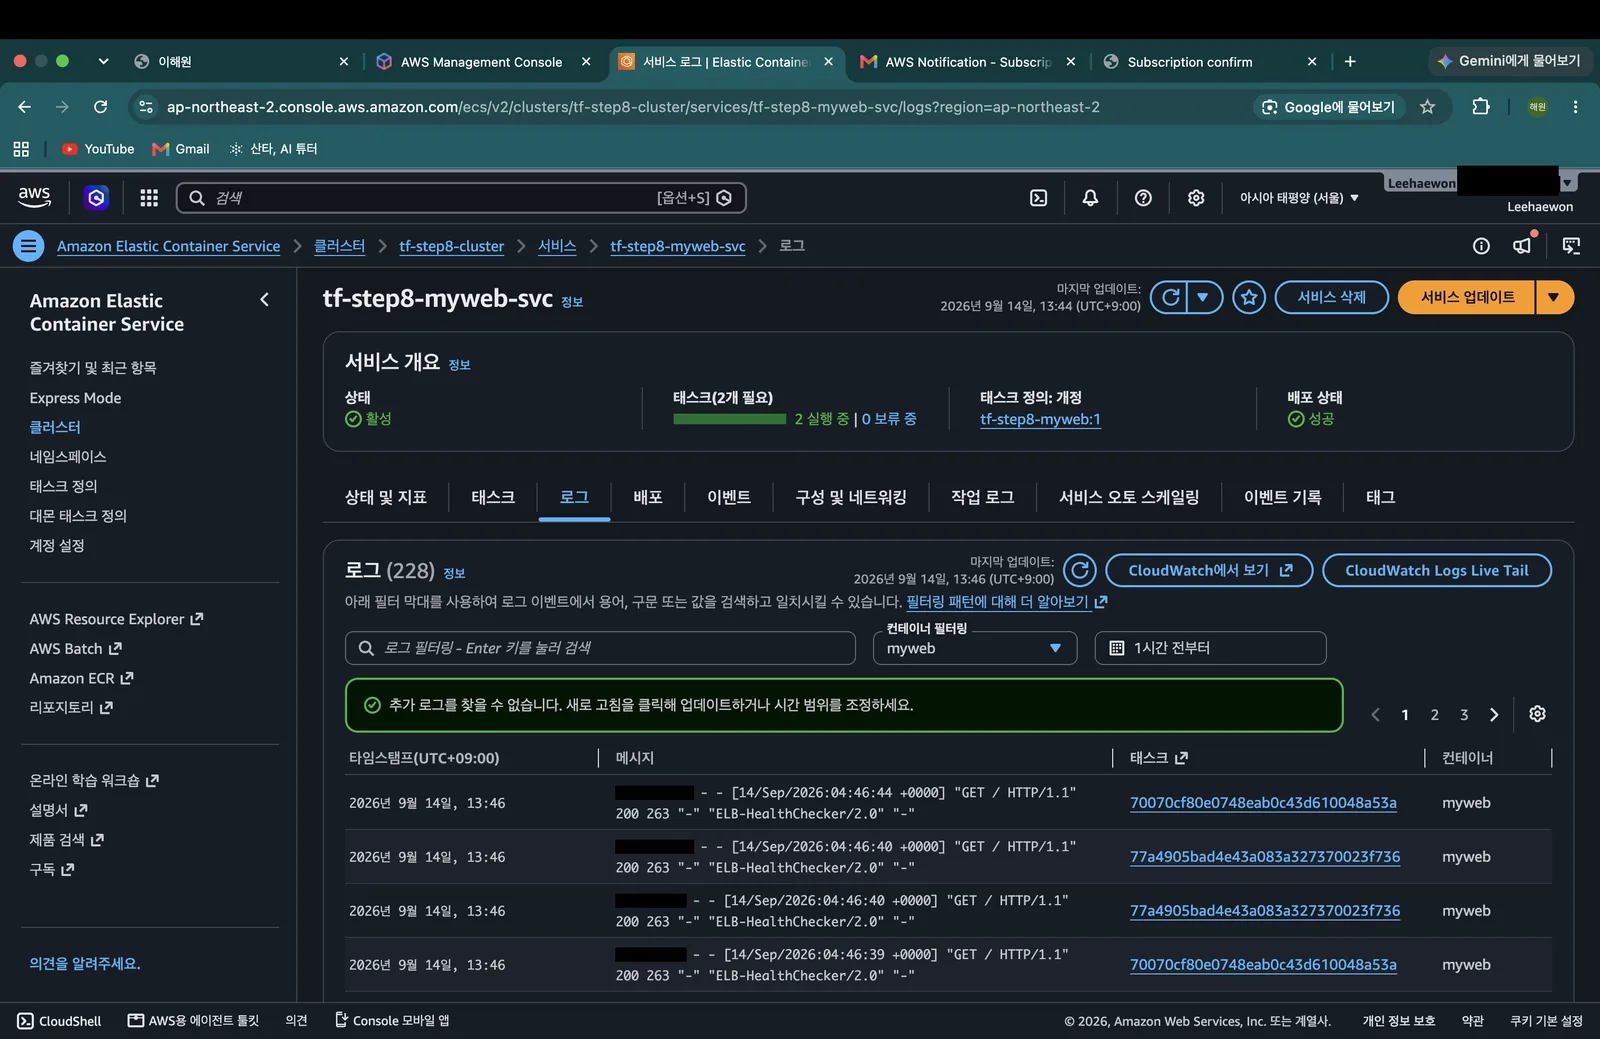
ECS 콘솔 → 서비스 → 로그 탭에서 확인했다.
관찰한 것
<내부 IP> - - [14/Sep/2026:04:46:44 +0000] "GET / HTTP/1.1" 200 263 "-" "ELB-HealthChecker/2.0"
<내부 IP>  - - [14/Sep/2026:04:46:40 +0000] "GET / HTTP/1.1" 200 263 "-" "ELB-HealthChecker/2.0"
- 228건 중 대부분이 헬스체크였다. 브라우저로 접속한 것은 몇 건뿐이고, 나머지는 ALB가 30초마다 보낸
GET /요청이다 - 요청 IP가
10.0.1.x,10.0.2.x다. 내 공인 IP가 아니라 ALB의 내부 IP이며, 컨테이너 입장에서는 ALB만 보이고 실제 사용자는 보이지 않는다. 보안 그룹으로 ALB에서 오는 트래픽만 허용했으므로 당연한 결과다 - 아무 트래픽이 없어도 로그는 계속 쌓인다. 로그 보관은 용량 기준으로 과금되므로 실습용 로그 그룹에는
retention_in_days = 1을 지정했다
2. 알림 경로 구성 (SNS)
# 알람이 터지면 여기로 던진다
resource "aws_sns_topic" "alerts" {
  name = "tf-step8-alerts"
}

# 던져진 것을 메일로 받는다
resource "aws_sns_topic_subscription" "email" {
  topic_arn = aws_sns_topic.alerts.arn
  protocol  = "email"
  endpoint  = "<내 이메일 주소>"
}
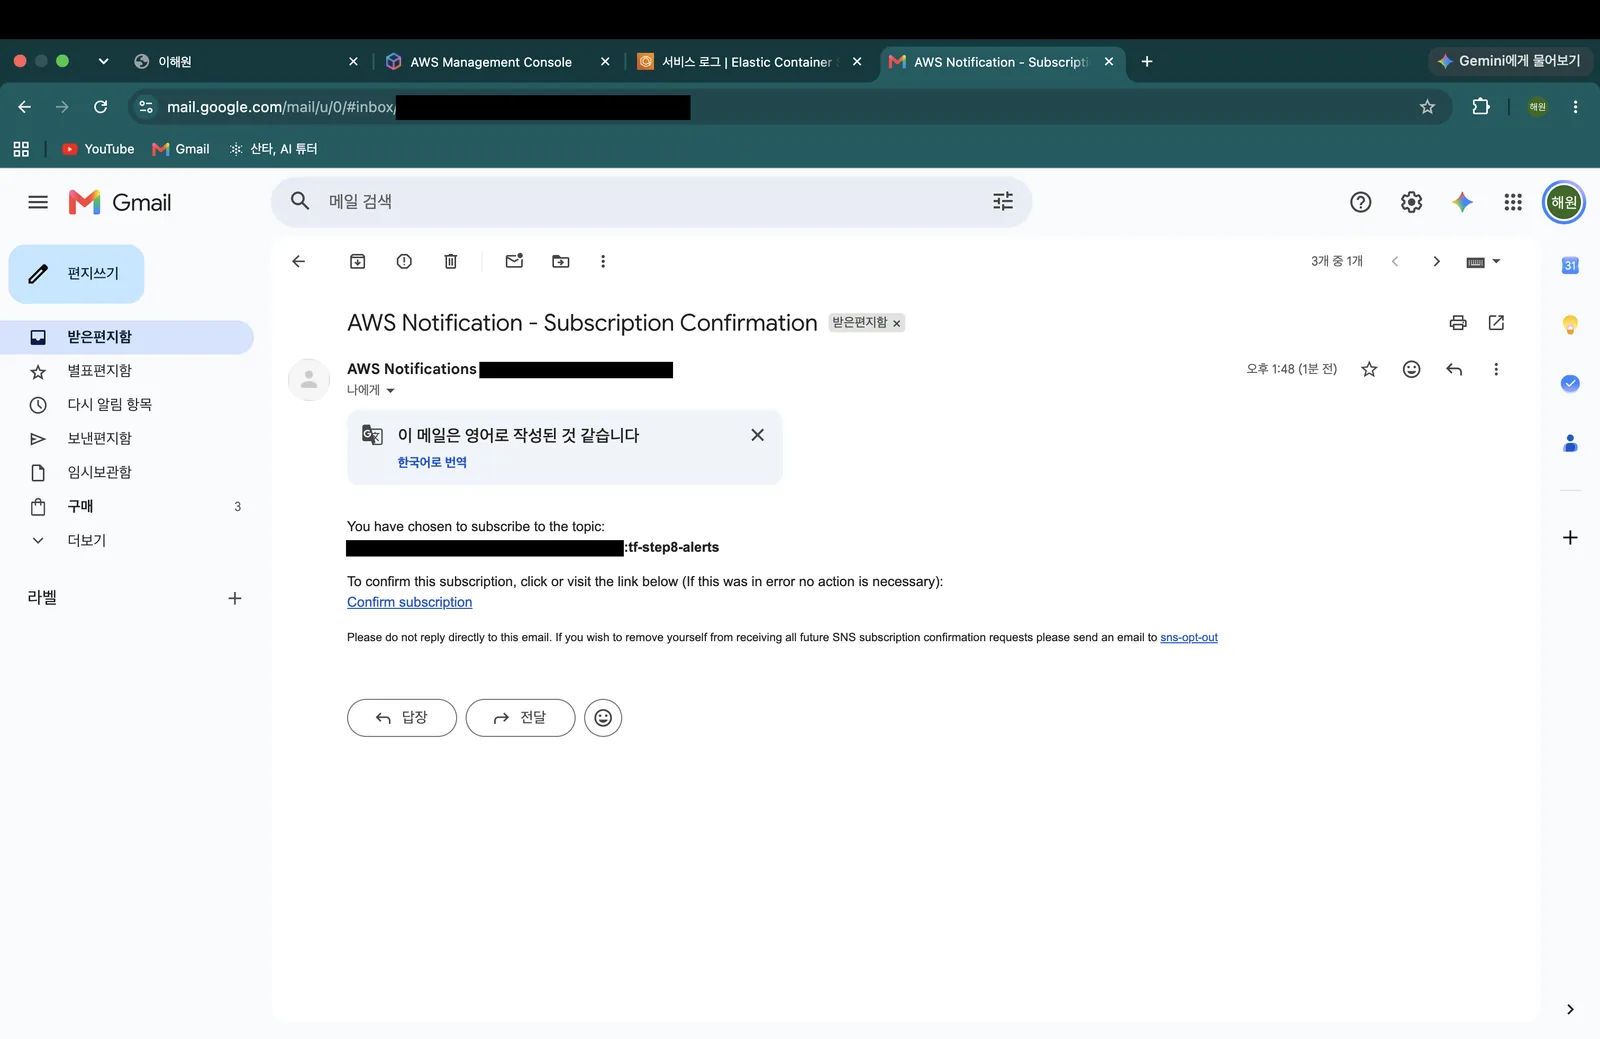
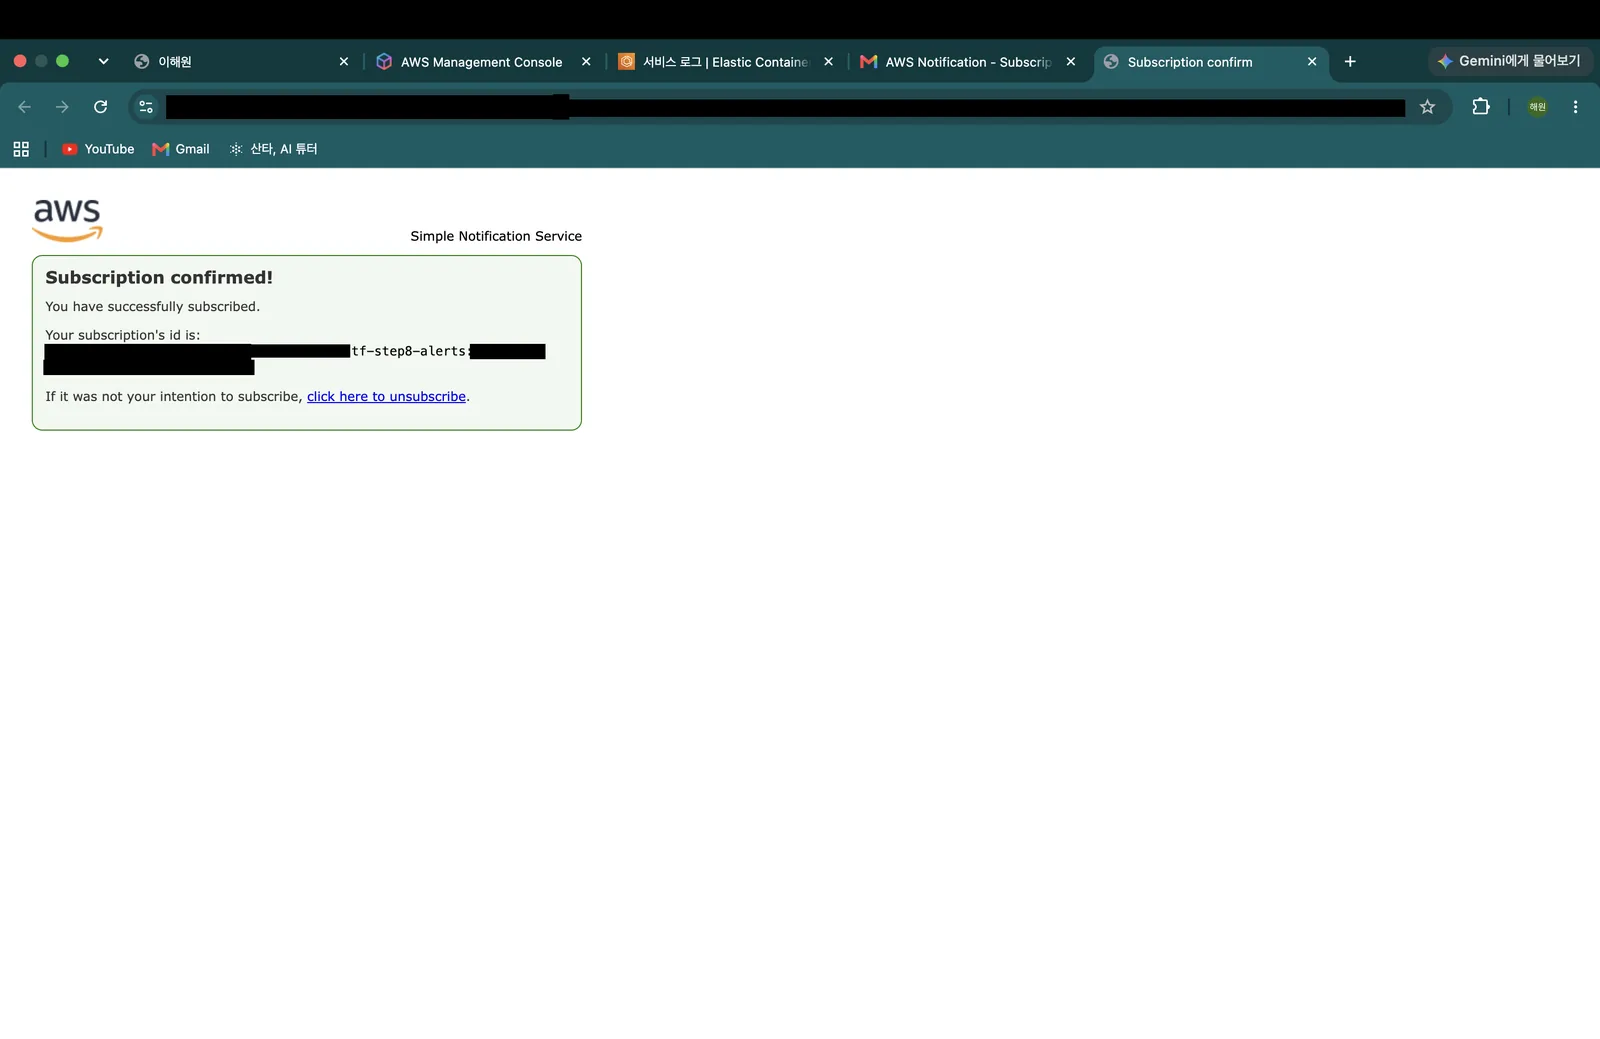
apply 직후에는 메일이 오지 않고 구독 확인 메일이 먼저 온다. 링크를 눌러야 구독이 PendingConfirmation에서 Confirmed로 바뀜다.
이 절차가 있는 이유는 아무나 타인의 이메일을 SNS에 등록해 스팸을 보낼 수 없게 하기 위해서다. 본인이 수락해야만 메일 발송이 시작된다.
실제로 겪은 문제
구독 확인 메일이 스팸함으로 분류되어 있었다.
알림 설정만 해두고 안심하면, 실제로 장애가 발생해도 메일을 보지 못하는 상태가 된다. 알림 채널은 설정으로 끝나는 것이 아니라 실제 수신까지 확인해야 한다는 것이 이 단계에서 가장 실무적인 교훈이었다.
3. 알람 두 개
# ① ECS CPU 사용률이 50% 초과
resource "aws_cloudwatch_metric_alarm" "cpu_high" {
  comparison_operator = "GreaterThanThreshold"
  metric_name         = "CPUUtilization"
  namespace           = "AWS/ECS"
  period              = 60
  statistic           = "Average"
  threshold           = 50

  alarm_actions = [aws_sns_topic.alerts.arn]
  ok_actions    = [aws_sns_topic.alerts.arn]

  dimensions = {
    ClusterName = aws_ecs_cluster.main.name
    ServiceName = aws_ecs_service.myweb.name
  }
}

# ② ALB가 5xx를 반환
resource "aws_cloudwatch_metric_alarm" "alb_5xx" {
  metric_name        = "HTTPCode_ELB_5XX_Count"
  namespace          = "AWS/ApplicationELB"
  statistic          = "Sum"
  threshold          = 0
  treat_missing_data = "notBreaching"

  dimensions = {
    LoadBalancer = aws_lb.main.arn_suffix
  }
}
두 알람의 성격이 다르다.
| 알람 | 의미 | 시점 |
|---|---|---|
| CPU 사용률 | 느려지고 있다 | 장애 전 경고 |
| ALB 5xx | 사용자가 이미 에러를 보고 있다 | 장애 발생 후 |
treat_missing_data = "notBreaching"을 지정한 이유는, 5xx가 한 건도 없으면 지표 자체가 기록되지 않아 "데이터 부족" 상태가 되기 때문이다. 에러가 없는 정상 상태를 경보로 취급하지 않도록 명시했다.
ok_actions를 함께 지정해 정상으로 돌아왔을 때도 메일이 오도록 했다. 복구 사실을 알아야 대응을 종료할 수 있다.
4. 알람 동작 검증
알람을 만들어 두는 것만으로는 알림 경로가 동작하는지 알 수 없다. AWS가 제공하는 알람 상태 강제 변경 기능으로 의도적으로 ALARM 상태를 발생시켜 수신을 검증했다.
aws cloudwatch set-alarm-state \
  --alarm-name tf-step8-ecs-cpu-high \
  --state-value ALARM \
  --state-reason "장애 주입 테스트: 알림 경로 검증" \
  --region ap-northeast-2
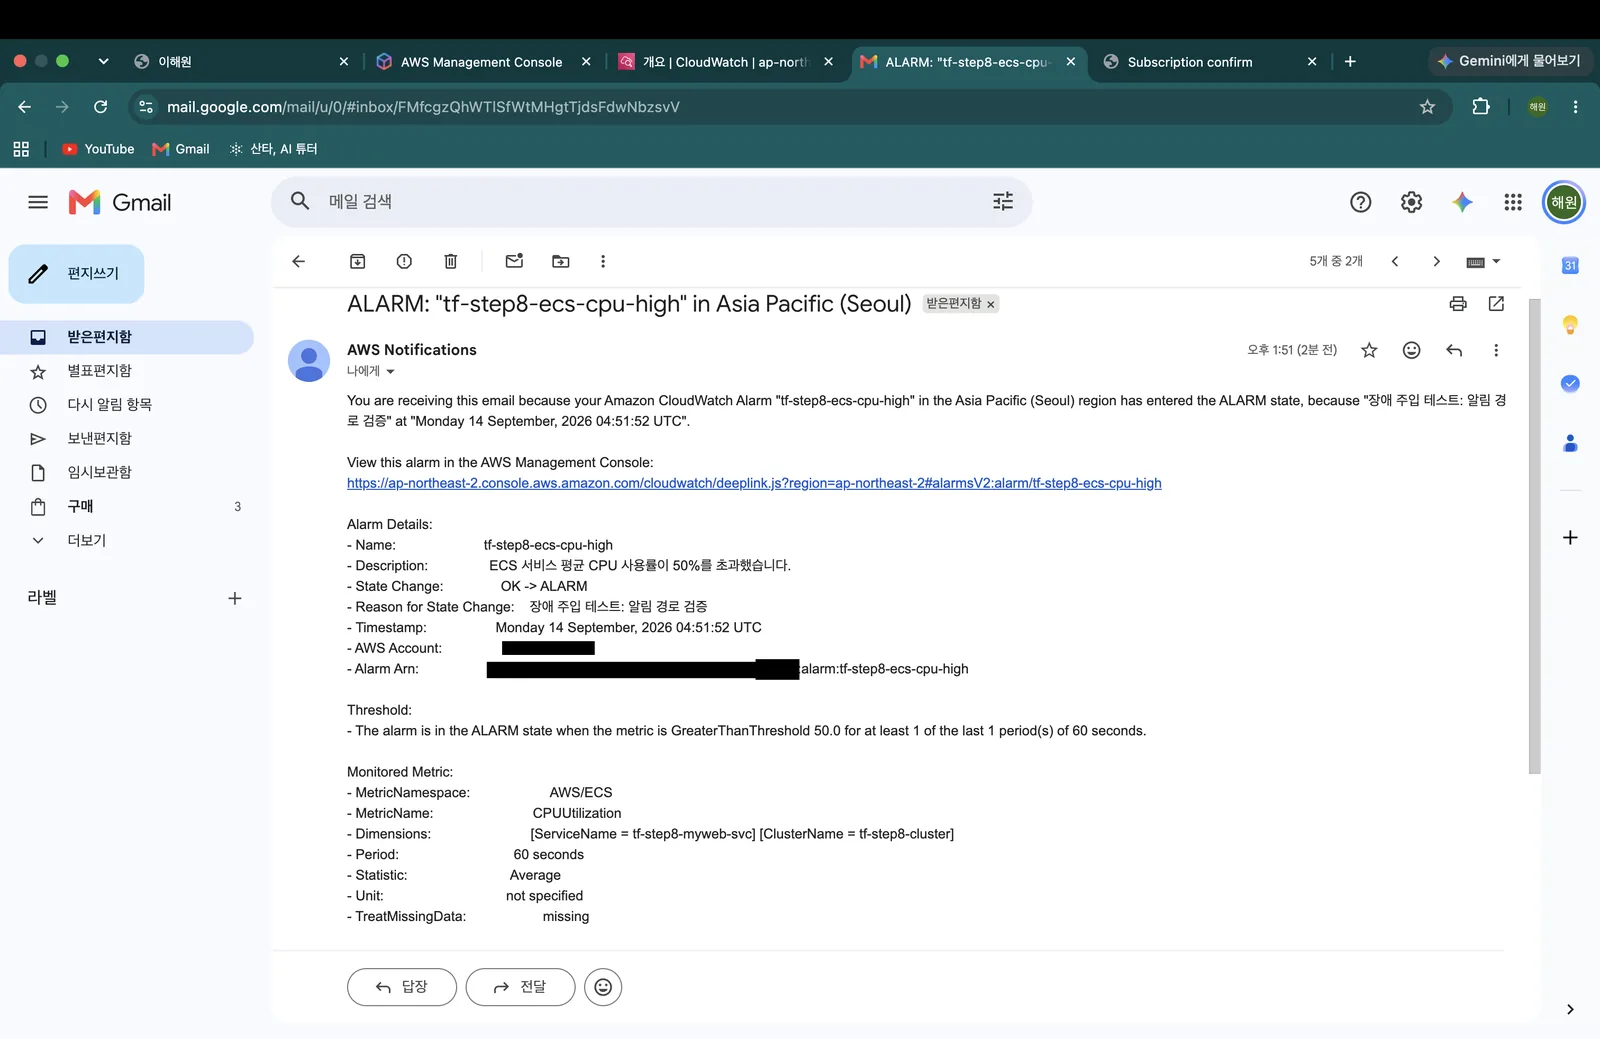
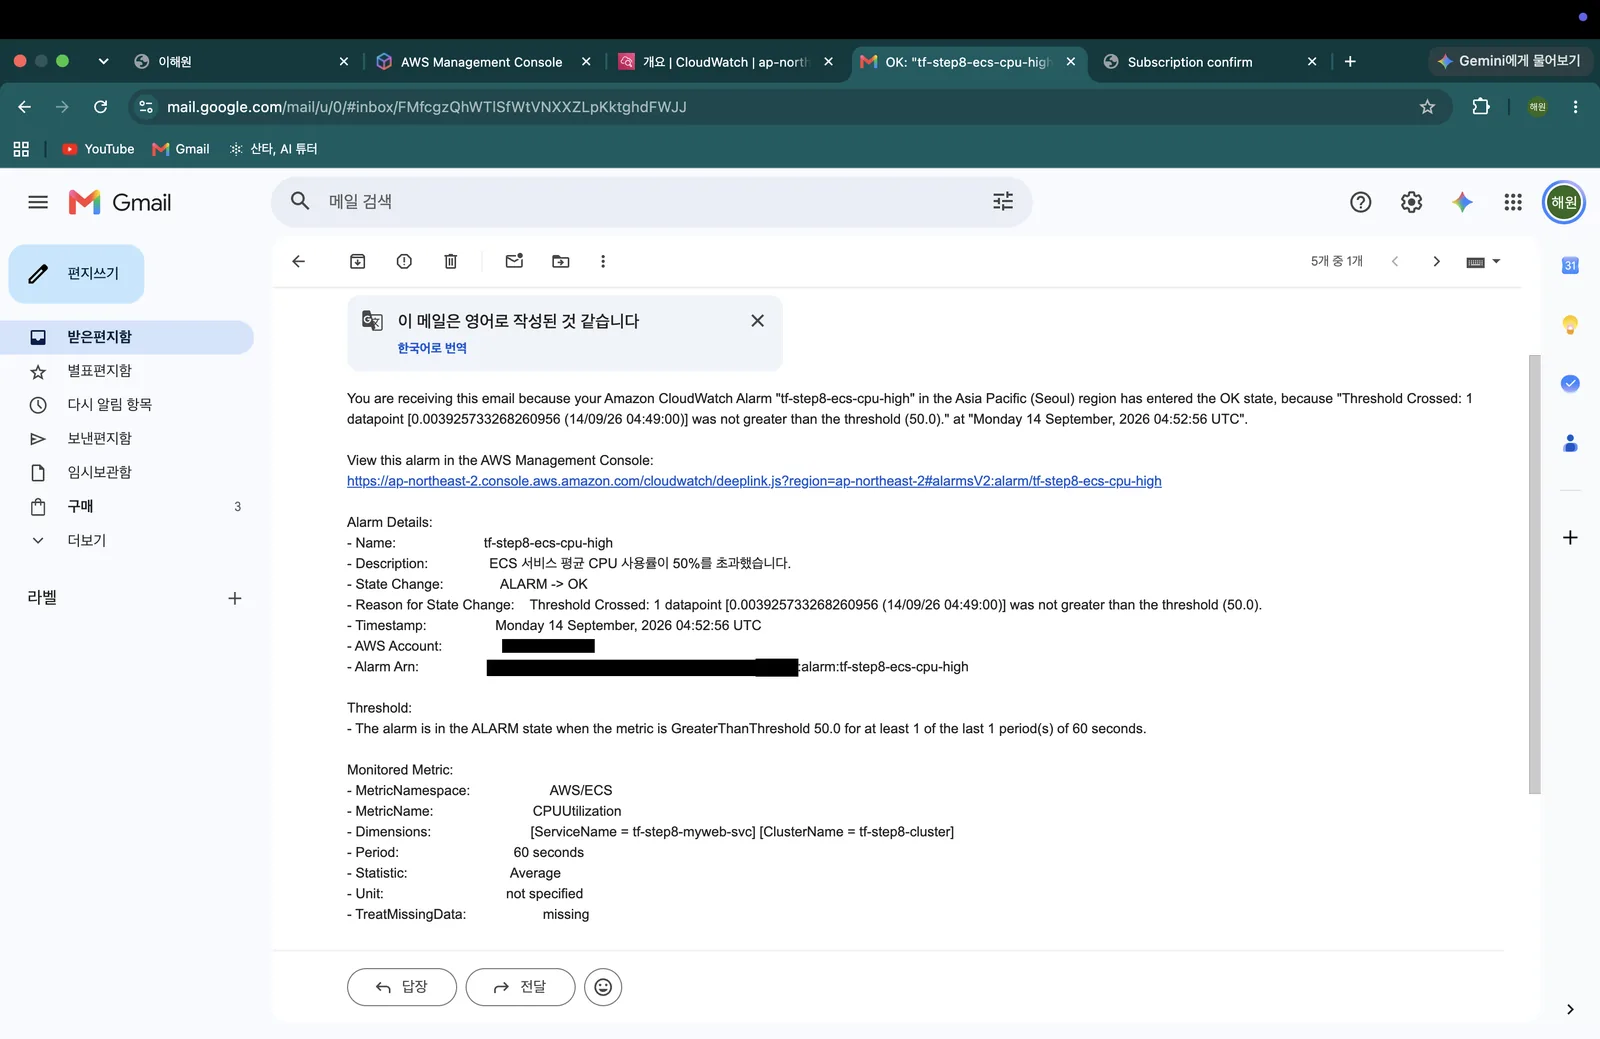
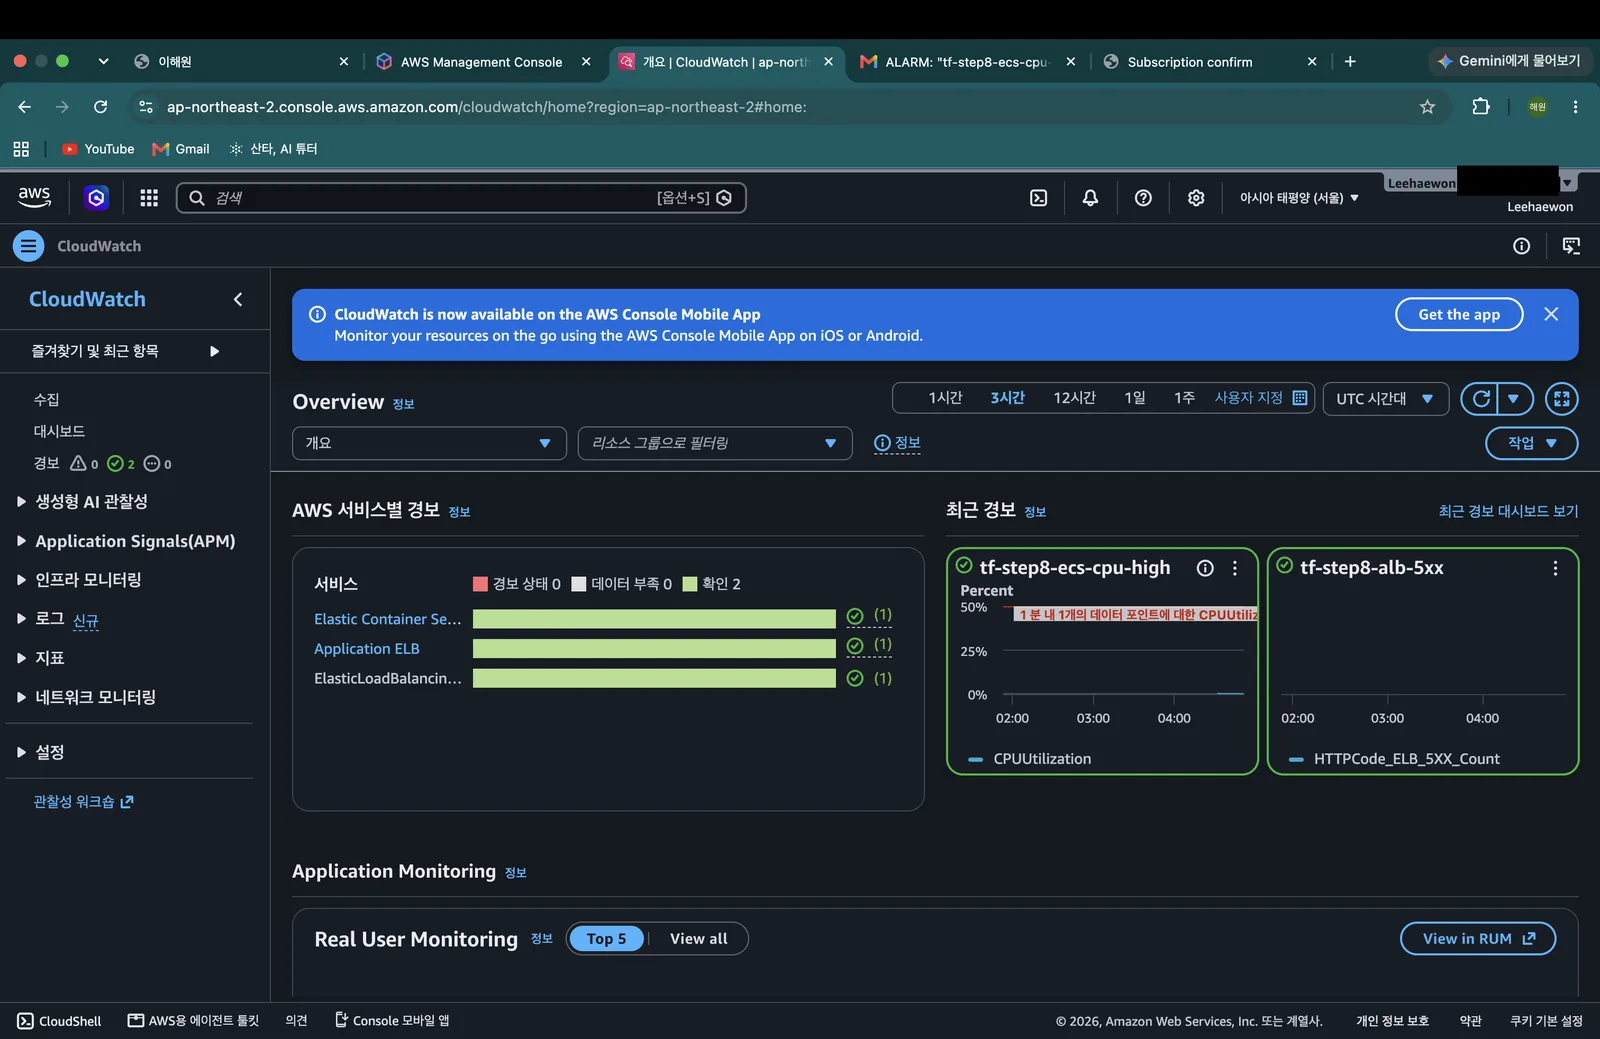
1~2분 안에 ALARM 메일이 수신되었고, 실제 CPU 사용률이 임계값보다 낮으므로 곷 자동으로 OK 상태로 돌아오며 OK 메일이 한 통 더 왔다.
확인한 것
- ALARM과 OK 두 통이 모두 왔다. 알림이 한 방향이 아니라 상태 변화 양쪽으로 동작한다는 뜻이다
- OK 메일의
Reason for State Change에 실제 측정값0.0039%가 찍혔다. 임계값 50%와 비교해 정상 판정이 내려진 근거가 메일에 그대로 남는다 - 이 알람은 실제 부하로 발생한 것이 아니라 알림 경로를 검증하기 위해 상태를 강제로 변경한 테스트다
5. 실습 리소스 정리
8단계와 9단계가 같은 인프라를 공유하므로 두 단계의 검증을 모두 마친 뒤 한 번에 삭제했다.
terraform destroy
aws_ecs_service.myweb: Destruction complete after 7m13s
aws_internet_gateway.main: Destruction complete after 7m39s
aws_vpc.main: Destruction complete after 0s

Destroy complete! Resources: 26 destroyed.
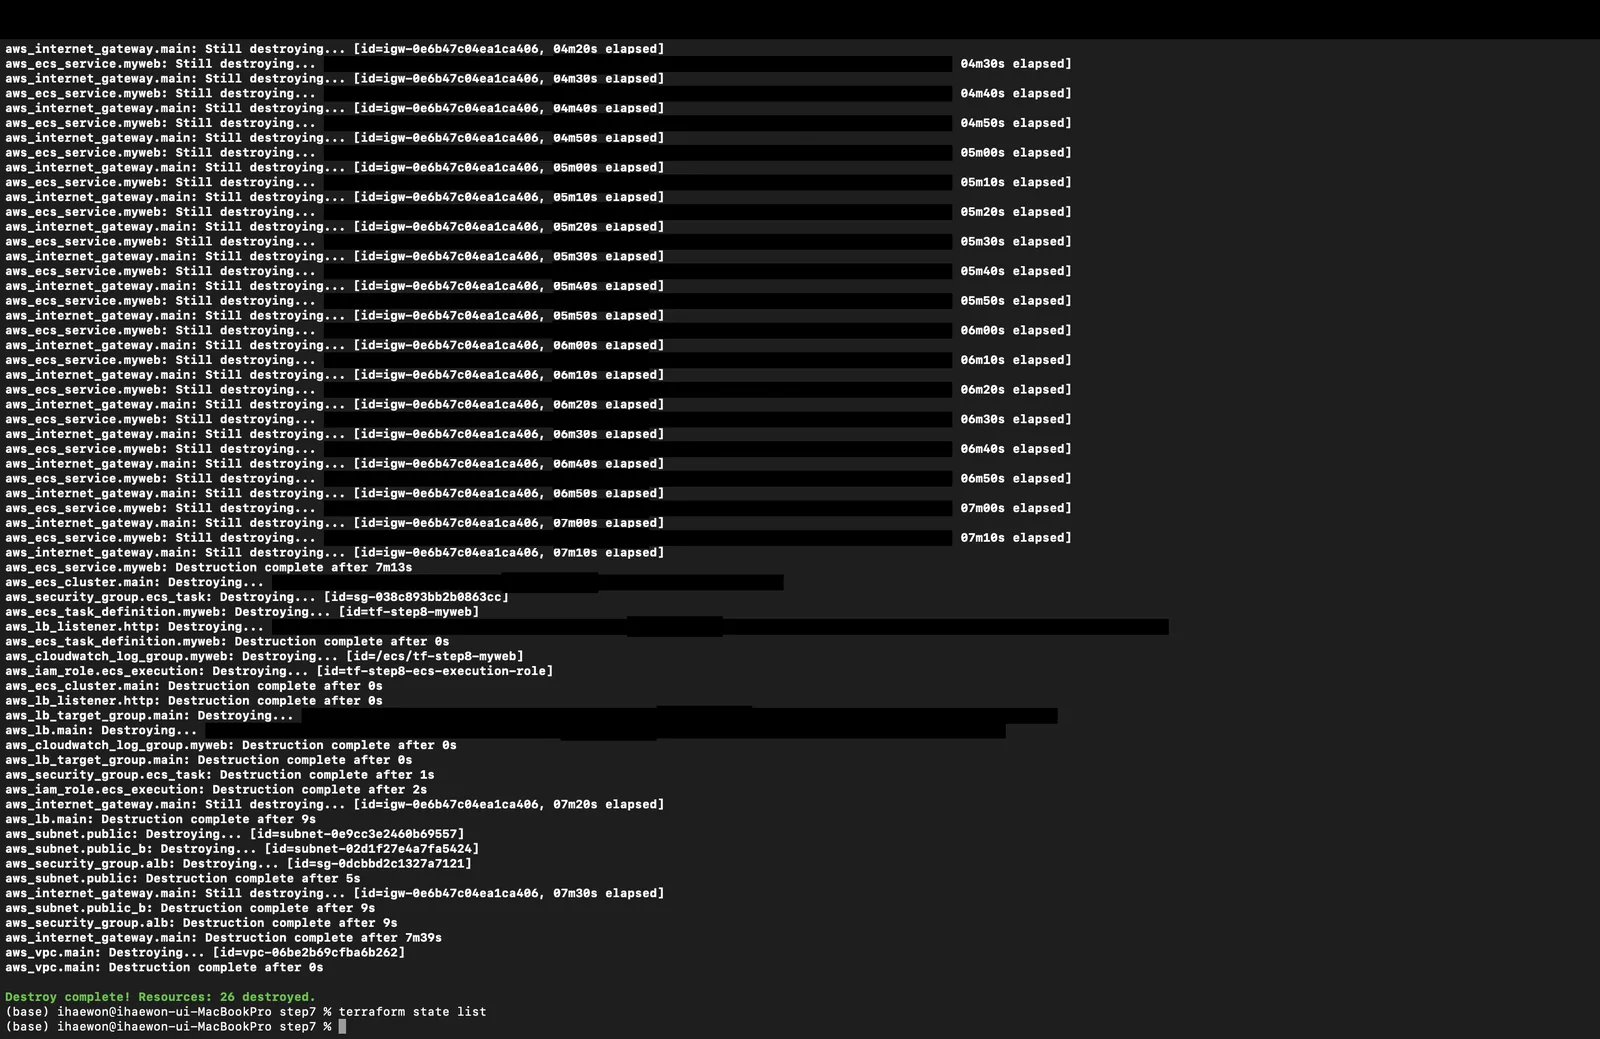
ECS 서비스 삭제에 7분 13초가 걸렸다. 실행 중인 태스크를 정리하고 ALB 타겟 그룹에서 등록을 해제하는 과정이 포함되기 때문이다. 인터넷 게이트웨이도 ALB가 완전히 삭제될 때까지 대기했다.
terraform state list로 아무 리소스도 남지 않은 것을 확인했다. ECR 리포지토리는 Terraform 관리 대상이 아니므로 그대로 남아 있으며, 프리티어 범위 안이라 비용이 발생하지 않는다.