목표
실제 환자 없이 서버를 시험하기 위해, 공개 심전도 데이터를 잘라서 가상 환자 N명이 실시간으로 보내는 것처럼 흉내 내는 생성기를 만든다.
기준
- 데이터: PhysioNet LTSTDB (Long-Term ST Database), 250Hz
- PhysioNet: 의료 데이터 공개 도서관
- LTSTDB: 그 안의 심전도 모음. 사람마다 21~24시간짜리 기록
- 250Hz: 1초에 250번 측정 = 4ms마다 점 하나
- 0.1초마다 25샘플씩 보냄 (250Hz × 0.1초)
- 샘플: 측정한 점 하나(숫자 하나)
- 0.1초 분량을 상자 하나에 담는 것. 점 하나씩 보내면 1초에 250번, 25개씩 묶으면 1초에 10번
- 환자마다 시작 위치를 다르게 해서 같은 파형이 동시에 나오지 않게 함
- 파일 하나로 여러 명을 흉내 내니까, 다 처음부터 틀면 100명이 똑같은 박동을 보냄. 환자 0은 3초부터, 1은 17초부터처럼 섞음
A. 데이터 읽기 (read_sample.py)
import wfdb            # PhysioNet 파일을 여는 파이썬 도구

# LTSTDB의 s20011 기록에서 처음 2500개(10초)만 읽기
record = wfdb.rdrecord("s20011", pn_dir="ltstdb", sampto=2500)   # 읽은 결과를 record에 담음
# rdrecord : read record. 기록 하나를 읽는 명령
# "s20011" : 읽을 기록(사람) 이름
# pn_dir="ltstdb" : PhysioNet의 LTSTDB 폴더에서 바로 읽어옴 (다운로드 불필요)
# sampto : 몇 번째 샘플까지 읽을지. 하루치를 다 읽으면 무거워서 2500개 = 10초만
#          (실제 재생하는 B·C는 FS * 60 = 15000개 = 1분)

print("샘플링 레이트:", record.fs)                # fs : 1초에 몇 번 측정했는지 (250)
print("채널 수:", record.n_sig)                   # n_sig : 리드 수 (s20011은 2)
print("채널 이름:", record.sig_name)              # sig_name : 리드 이름
print("데이터 모양:", record.p_signal.shape)      # shape : 표의 크기 (2500, 2) = 2500줄 × 2리드
print("처음 5개 값:")
print(record.p_signal[:5])                        # p_signal : 측정값 표. [:5] = 앞 5줄만
# s20011은 2리드라서 3단계에서 3리드 데이터로 바꿈
자세히 보기
1. 생성기가 왜 필요한가
- 서버가 환자 100명을 버티는지 재려면 환자 100명이 필요함. 진짜 환자는 없으니까 공개 심전도 파일을 재생해서 흉내 냄
- 비유: 택배 물류센터 개장 전에 가짜 상자를 쏟아봐서 막히는 곳을 찾는 것
B. 환자 1명 (stream_one.py)
- 0.1초마다 25샘플씩 잘라서 내보내는 구조만 확인
- 보내는 곳 없이 화면에 찍기만 함. 0.1초 박자대로 잘 나오는지 보는 단계
import time            # 시간 재기·기다리기용 기본 도구
import wfdb            # PhysioNet 파일을 여는 파이썬 도구

FS = 250               # 초당 샘플 수 (250Hz)
CHUNK = 25             # 한 번에 보내는 개수 (250 × 0.1초 = 25)
INTERVAL = CHUNK / FS  # 상자 보내는 간격 (25 / 250 = 0.1초)

# 1분 분량 읽어두고 반복 재생
record = wfdb.rdrecord("s20011", pn_dir="ltstdb", sampto=FS * 60)   # 250 × 60 = 15000개 = 1분
signal = record.p_signal   # 읽은 측정값 표만 꺼내 둠

def send(patient_id, chunk):   # 보내는 함수 자리. 3단계에서 TCP 전송으로 채움
    pass                       # pass : 아무것도 안 함. 자리만 만들어 둘 때 씀

pos = 0                        # 지금 몇 번째 샘플까지 보냈는지. 처음부터 시작
start = time.perf_counter()    # 시작 시각 기록
# time.perf_counter() : 시간 재는 용도의 정밀한 시계
next_tick = start              # 첫 박자를 시작 시각으로 맞춤

while time.perf_counter() - start < 10:   # 시작하고 10초 동안 반복
    chunk = signal[pos:pos + CHUNK]       # pos번째부터 25개 잘라내기
    send(0, chunk)                        # 환자 0번으로 보내기 (지금은 아무 일 안 함)
    pos = (pos + CHUNK) % len(signal)     # 다음 25개로 이동
    # % : 나머지. 1분 끝에 닿으면 0으로 돌아가 처음부터 다시 재생

    next_tick += INTERVAL                 # 다음 보낼 시각을 0.1초 뒤로 정함
    time.sleep(max(0, next_tick - time.perf_counter()))   # 그 시각까지 남은 만큼만 잠
    # max(0, ...) : 이미 늦어서 음수면 0초 (음수로는 못 잠)
    # next_tick 방식 : sleep(0.1)만 하면 보내는 시간만큼 계속 밀림 (2ms씩 100번 = 0.2초)
    #                 다음 시각을 정해두면 한 번 늦어도 다음 박자는 제자리
- 실제 파일에는 1초마다 누적 개수를 화면에 찍는 줄이 더 있음 (여기선 생략)
자세히 보기
2. 숫자 감 잡기
| 숫자 | 뜻 |
|---|---|
| 250Hz | 1초에 250번 측정 = 4ms마다 점 하나 |
| 0.1초 × 250 = 25 | 상자 하나에 리드당 숫자 25개 |
| 환자 1명 | 1초에 상자 10개, 숫자 250개 (리드당) |
| 환자 100명 | 1초에 상자 1,000개, 숫자 25,000개 (리드당) |
- 한 점씩 보내면 1초에 250번 보내야 해서 부담이 큼. 실제 장비도 묶어서 보내니까 0.1초 묶음으로 보냄
C. 환자 N명 (stream_multi.py)
- 환자 수를 실행 인자로 받음
- 실행 인자: 프로그램 이름 뒤에 붙이는 값.
python stream_multi.py 20이면 환자 20명
- 실행 인자: 프로그램 이름 뒤에 붙이는 값.
next_tick방식: 매번 0.1초씩 자는 게 아니라 다음 보낼 시각을 정해두고 그때까지만 대기 → 처리 시간만큼 늦어지는 걸 막음- next_tick: 다음에 보낼 시각. 메트로놈처럼 박자를 미리 정해둠 (아래 자세히 보기)
- sleep: 정해진 시간만큼 멈춰 기다리는 것
- 목표 개수, 실제 개수, 최대 지각을 출력해서 생성기 자체가 늦지 않은지 확인
- 최대 지각: 정해둔 시각보다 가장 늦게 보낸 정도. 이게 커지면 생성기가 박자를 못 따라가는 것
import sys             # 실행 인자 읽는 기본 도구
import random          # 난수 뽑는 기본 도구
import time
import wfdb

FS = 250               # (B와 같음)
CHUNK = 25
INTERVAL = CHUNK / FS
record = wfdb.rdrecord("s20011", pn_dir="ltstdb", sampto=FS * 60)
signal = record.p_signal

def send(patient_id, chunk):
    pass

N = int(sys.argv[1]) if len(sys.argv) > 1 else 6   # 환자 수. 실행할 때 붙인 숫자, 없으면 6명
# sys.argv : 실행 명령을 칸별로 담은 목록. python stream_multi.py 20 → ["stream_multi.py", "20"]
# sys.argv[1] : 두 번째 칸 = "20" (0번 칸은 파일 이름)
# int() : 글자 "20"을 숫자 20으로 바꿈
# len(sys.argv) > 1 : 숫자를 붙였는지 확인 (안 붙이면 칸이 1개뿐)
# A if 조건 else B : 조건이 맞으면 A, 아니면 B
DURATION = 10                                     # 측정 시간(초)

# 환자마다 시작 위치를 다르게
positions = [random.randrange(0, len(signal), CHUNK) for _ in range(N)]
# random.randrange(시작, 끝, 간격) : 0~15000 사이에서 25 간격으로 난수 하나 (0, 25, 50 ...)
#                                   25 간격이라 상자 경계에 딱 맞음
# [ ... for _ in range(N)] : 앞의 것을 N번 해서 목록으로 만듦 → 환자 N명분 시작 위치
# _ : 반복 횟수만 필요하고 번호는 안 쓸 때 쓰는 이름

sent = 0               # 지금까지 만든 샘플 수. 마지막에 초당 개수 계산용
max_late = 0.0         # 최대 지각. 처음엔 0
start = time.perf_counter()
next_tick = start

while time.perf_counter() - start < DURATION:   # 10초 동안 반복
    for pid in range(N):                        # 환자 0번부터 N-1번까지 차례로
        p = positions[pid]                      # 이 환자가 지금 보낼 위치
        chunk = signal[p:p + CHUNK]             # 거기서 25개 잘라내기
        send(pid, chunk)                        # 환자 번호 붙여서 보내기 (지금은 빈 함수)
        sent += len(chunk)                      # 만든 개수에 25 더함
        # += : 원래 값에 더해서 다시 저장 (sent = sent + 25)
        positions[pid] = (p + CHUNK) % len(signal)   # 이 환자 다음 위치로. 끝이면 처음으로

    next_tick += INTERVAL                       # 다음 박자를 0.1초 뒤로 정함
    wait = next_tick - time.perf_counter()      # 다음 박자까지 남은 시간
    if wait < 0:                                # 음수 = 정해둔 시각이 이미 지남 = 지각
        max_late = max(max_late, -wait)         # 지금까지 지각 중 가장 큰 값만 남김
    time.sleep(max(0, wait))                    # 남은 만큼 잠. 지각했으면 안 자고 바로 다음

elapsed = time.perf_counter() - start           # 실제로 걸린 시간
print(f"환자 {N}명 | 목표 초당 {N * FS}개 | 실제 초당 {round(sent / elapsed)}개 | 최대 지각 {max_late * 1000:.1f}ms")
# f"...{값}..." : 글자 안에 {} 자리에 값을 넣어 출력
# N * FS : 목표 = 환자 수 × 250
# round(sent / elapsed) : 실제 초당 개수, 반올림
# max_late * 1000 : 초 → ms
# :.1f : 소수점 한 자리까지
자세히 보기
3. 박자 맞추기 (next_tick)
next_tick = start
for _ in range(ticks):
    보내기()
    next_tick += 0.1                    # 다음에 보낼 시각을 정해두고
    time.sleep(next_tick - time.time())  # 그때까지만 기다림
- 나쁜 방법: 매번
sleep(0.1). 보내는 데 2ms 걸리면 한 바퀴가 0.102초 → 100번 돌면 0.2초 밀림. 오차가 계속 쌓임 - 좋은 방법: “다음 시각”을 미리 정해두고 남은 시간만 기다림. 한 번 늦어도 다음에 따라잡음
- 비유: 메트로놈. 내가 늦게 쳐도 다음 박자는 제자리에 옴
- 최대 지각 = 정해둔 시각보다 가장 늦게 보낸 정도. 이게 커지면 생성기 자체가 못 따라가는 것
4. 환자마다 시작 위치 다르게
- 파일 하나로 여러 명을 흉내 내니까 같은 위치에서 시작하면 100명이 똑같은 파형을 보냄
- 그래서 환자마다 시작 위치를 다르게 함. 단 난수라 실행마다 달라져서 회차 비교가 어렵다는 검토 의견 있음 (고정값으로 바꿀 예정)
D. 결과
- 환자 100명 기준 초당 목표 25,000샘플 중 24,999샘플 생성
- 만드는 속도만 잰 것. 서버로 보내는 부분(
send)은 비워둠- send: 서버로 보내는 함수. 3단계에서 TCP 전송으로 채움
- 25,000 / 24,999: 환자 100명 × 점 250개 = 목표. 거의 다 만들었으니 박자를 안 놓침
자세히 보기
5. D 결과가 뜻하는 것
- 24,999 / 25,000 = 생성기가 박자를 놓치지 않고 만들 수 있다는 뜻
- 아직 아무 데도 안 보냈으니 “서버가 버틴다”는 뜻은 아님. 보내는 건 3단계, 받아서 처리하는 건 4단계
E. 코드 검토 (팀원)
- 검토 의견 8건 받음. 메시지 형식이 정해져야 고칠 수 있는 것들이 있어 일부 보류
- 메시지 형식: 상자에 붙이는 송장 양식 (2단계에서 정함)
- 생성기를 서버와 같은 컴퓨터에서 돌리면 서버 성능이 낮게 나올 수 있다는 지적 → 개발 단계는 같이, 최종 측정만 분리하기로 함
- 같은 컴퓨터면 생성기와 서버가 CPU를 나눠 써서 서버가 느려 보일 수 있음. 대신 시계가 같아서 지연 계산은 정확함
배운 점
직접 작성목표
-
공개 심전도 데이터 (LTSTDB) 로 가상 환자 N명이 실시간으로 보내는 것 처럼 흉내내는 생성기 만듦
- 생성기 : 데이터를 만들어 내보내는 프로그램 (가짜 환자 역할)
- 실시간 : 실제 시간 흐름대로 조금씩 보냄
-
기준
- 데이터 : LTSTDB (PhysioNet) , 250Hz
- Hz : 1초에 몇 번 , 250Hz = 1초에 250번 측정
- LTSTDB : PhysioNet (병원, 연구소가 연구용으로 공개한 의료 데이터 사이트) 안의 심전도 묶음, 사람마다 하루치 기록
- 4ms : 1 / 250 = 0.004초 (측정과 측정 사이 간격)
- 샘플 : 측정한 숫자 하나, 그 순간의 전압값
- 0.1초마다 25샘플씩 보냄 —> 250(1초) x 0.1초 = 25개 (묶으면 1초에 10번이라 훨씬 가벼워짐)
- 환자마다 시작위치 다르게 세팅
- 데이터 : LTSTDB (PhysioNet) , 250Hz
-
전체 흐름
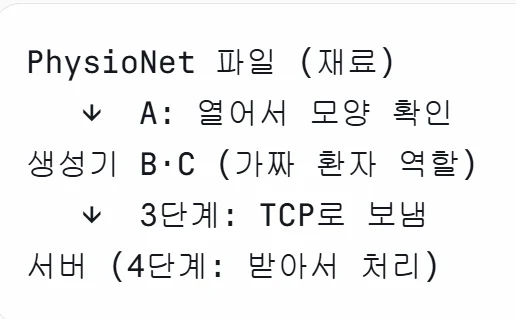
-
기초 용어
- 샘플 (sample) : 1개 = 1/250초 (0.004초)의 점 하나.
- 리드 3개면 숫자 3개
- 청크 (chunk) : 0.1초 분량 25샘플을 잘라낸 덩어리. 코드의 CHUNK = 25
- 우리는 이걸 상자라고 표현
- 1개 = 0.1초 = 샘플 25개 [3,25]
- 메시지 (message) : 청크에 환자 번호·순번·시각을 붙여서 보내는 한 건
- 상자 보내는 단위
- 청크 1개를 JSON으로 포장 → 생성기가 0.1초마다 보냄
- 창 (Window) : 1개 = 5초 = 메시지 50개 = 샘플 1,250개 [3, 1250]
- AI가 한 번 판정하는 단위. 처음 5초가 모이면 1번, 그 뒤로는 1초씩 밀며 1번씩
- 메시지 형식 (스키마) : 메시지에 어떤 칸이 들어갈지 정한 양식 (= 송장 양식, 2단계 C)
- 패킷과 다름 : 패킷은 네트워크가 내부적으로 데이터를 쪼개는 더 낮은 단계의 단위
- 샘플 (sample) : 1개 = 1/250초 (0.004초)의 점 하나.
-
5초 묶음(창, AI가 한 번에 판정, 청크 50개 → 샘플 1250개) —> 1초 = 청크 10개 —> 청크 1개 = 0.1초 = 샘플 25개 —> 샘플 1개 4ms (0.004초) ——> 1초에 250개 샘플 (25 * 10 = 250)
-
청크 1개 + 송장 = 메시지 → 0.1초마다 TCP로 보냄
A. 데이터 읽기 (read_sample.py)
- 목적 : 공개 심전도 파일에서 앞 10초만 읽어오기
- 몇 Hz인지, 리드가 몇 개인지, 표가 어떻게 생겼는지 알아야 B와 C에 사용한 코드에 잘라 보낼 수 있어서 사용함
- 설명 : s20011 의 사람을 physioNet의 ltstdb에서 sampto 2500개 (=10초) 까지만 읽어서 데이터 모양 확인
- 확인하는 것 : 250Hz, 2리드, 표 모양 2500줄 X 2칸 (한 줄 = 한 순간, 한 칸 = 리드 하나)
- 리드 : 심전도를 재는 방향 (채널), 리드가 많을 수록 심장을 여러 각도에서 확인
- 2리드 → 3리드 : 기업 기기가 3리드라서 3단계에서 3리드 데이터 변경
- B,C는 같은 방식으로 1분치 (15,000개)를 읽어서 사용
B. 환자 1명 (stream_one.py)
- 목적 : 환자 1명이 0.1초마다 심전도 25개씩 보내는 흉내 내기. 여러 명으로 늘리기 전에 1명으로 박자대로 잘 잘리는지 먼저 확인
- stream : 한꺼번에 보내지 않고 조금씩 계속 흘려보내는 것
- 1명부터 한 이유 : 여러 명으로 늘리기 전에 박자대로 잘 잘리는지 먼저 확인
- 설명 : 1분치를 읽어두고 25개씩 잘라서 0.1초 박자로 10초 동안 반복 재생. 아직 보내지는 않음
- 반복 재생 : 하루치 기록을 다 읽으면 무거워서 1분만 읽고 돌려씀
- 아직 안 보내는 이유 : 받을 서버가 아직 없음. 보내는 건 3단계(TCP)
C. 환자 N명 (stream_multi.py)
- 목적 : 환자 N명이 각자 다른 파형을 0.1초 박자에 맞춰 보내게 하기
- 시작 위치를 다르게 한 이유 : 파일 하나로 여러 명을 흉내 내므로 다 처음부터 틀면 전원이 똑같은 박동을 보내게 됨
- 설명 : B (1명)를 N명으로 늘리는 버전. 0.1초마다 N명 청크를 차례로 만들고, 끝나면 결과를 출력해서 생성기가 박자를 따라가는지 확인
- 흐름 : 0.1초마다 환자 0번→1번…→ N-1번 순서로 25개씩 잘라 청크를 만듦. 한 바퀴 다 돌면 다음 박자까지 기다린다.
- 6명이면 0.1초마다 청크 6개 , 1초에 60개
- B에서 바뀐 것 : 환자 수를 실행할 때마다 정함, 환자마다 시작 위치를 다르게 한다, 끝나고 결과 출력한다.
- 시작위치 : 환자 0은 3초부터 1은 17초부터 랜덤으로 뽑음. 25 간격으로 뽑아서 상자 경계에 맞춘다.
- 실행 인자 : 프로그램 이름 뒤에 붙이는 값, 코드 고치지 않고 20명, 100명으로 바꿔 돌리기 가능
- 출력 3개 : 목표 개수 (환자 X 250) / 실제 개수 / 최대 지각 → 목표랑 실제가 같고 지각이 작으면 생성기는 OK
- 250 : 1초 동안 찍는 점의 개수
- 최대 지각 : 정해둔 시각보다 가장 늦게 보낸 정도. 크면 생성기 자체가 느린 거라 측정을 못 믿음
- 아직 만들기만 하고 보내진 않음 , 보내는 과정은 3단계에 수행
- 흐름 : 0.1초마다 환자 0번→1번…→ N-1번 순서로 25개씩 잘라 청크를 만듦. 한 바퀴 다 돌면 다음 박자까지 기다린다.
D. 결과
- 목적 : 생성기가 환자 100명 분량을 박자 안 놓치고 만들어낼 수 있는지 확인
- 생성기가 느리면 나중에 서버를 시험할 때 서버가 느린건지 생성기가 느린 건지 구분하기 힘들기 때문에 확인한다.
- 설명 : C를 환자 100명으로 돌림 → 초당 목표 25,000 개 중 24,999 생성 —> 박자 놓치지 않음
- python stream_multi.py 100 으로 실행 → 10초 동안 돌림 → 끝나고 출력 3개 (목표 개수, 실제 개수, 최대 지각) 확인
- 25,000 : 목표 개수. 환자 100명 X 1초에 250개
- 24,999 : 실제 개수.
- 한계 : 만들기만 하고 아직 보내진 않음. 그래서 아직 서버가 100명을 버티는지 확인할 수 없음
- 보내기 (3단계, TCP), 받아서 처리는 4단계
- python stream_multi.py 100 으로 실행 → 10초 동안 돌림 → 끝나고 출력 3개 (목표 개수, 실제 개수, 최대 지각) 확인
E. 코드 검토 (팀원)
- 목적 : 팀원에게 생성기 코드를 검토받아서 고칠 점 찾기
- 설명 : 메시지 형식이 정해져야 고칠 수 있는 건 보류
- 메시지 형식 : 상자에 붙이는 송장 양식.
- 누가 몇 번째로 언제 보냈는지 적는 칸.
- 메시지 형식 : 상자에 붙이는 송장 양식.
- 지적
- 생성기랑 서버를 같은 컴퓨터에 돌리면 서버 성능이 낮게 나올 수 있음
- 이유 : 둘이 CPU를 나눠 써서 서버가 실제보다 느릴 수 있음
- 장점 : 시계가 같아서 지연(받은시간 - 보낸시각) 계산이 정확함
- 결정 : 개발할 때는 같이 돌리고 최종 측정에만 컴퓨터를 분리함.
- 시작 위치를 랜덤으로 뽑으면 실행할 때마다 달라져 회차끼리 비교가 어려움 —> 고정값으로 바꿀 예정
- 생성기랑 서버를 같은 컴퓨터에 돌리면 서버 성능이 낮게 나올 수 있음